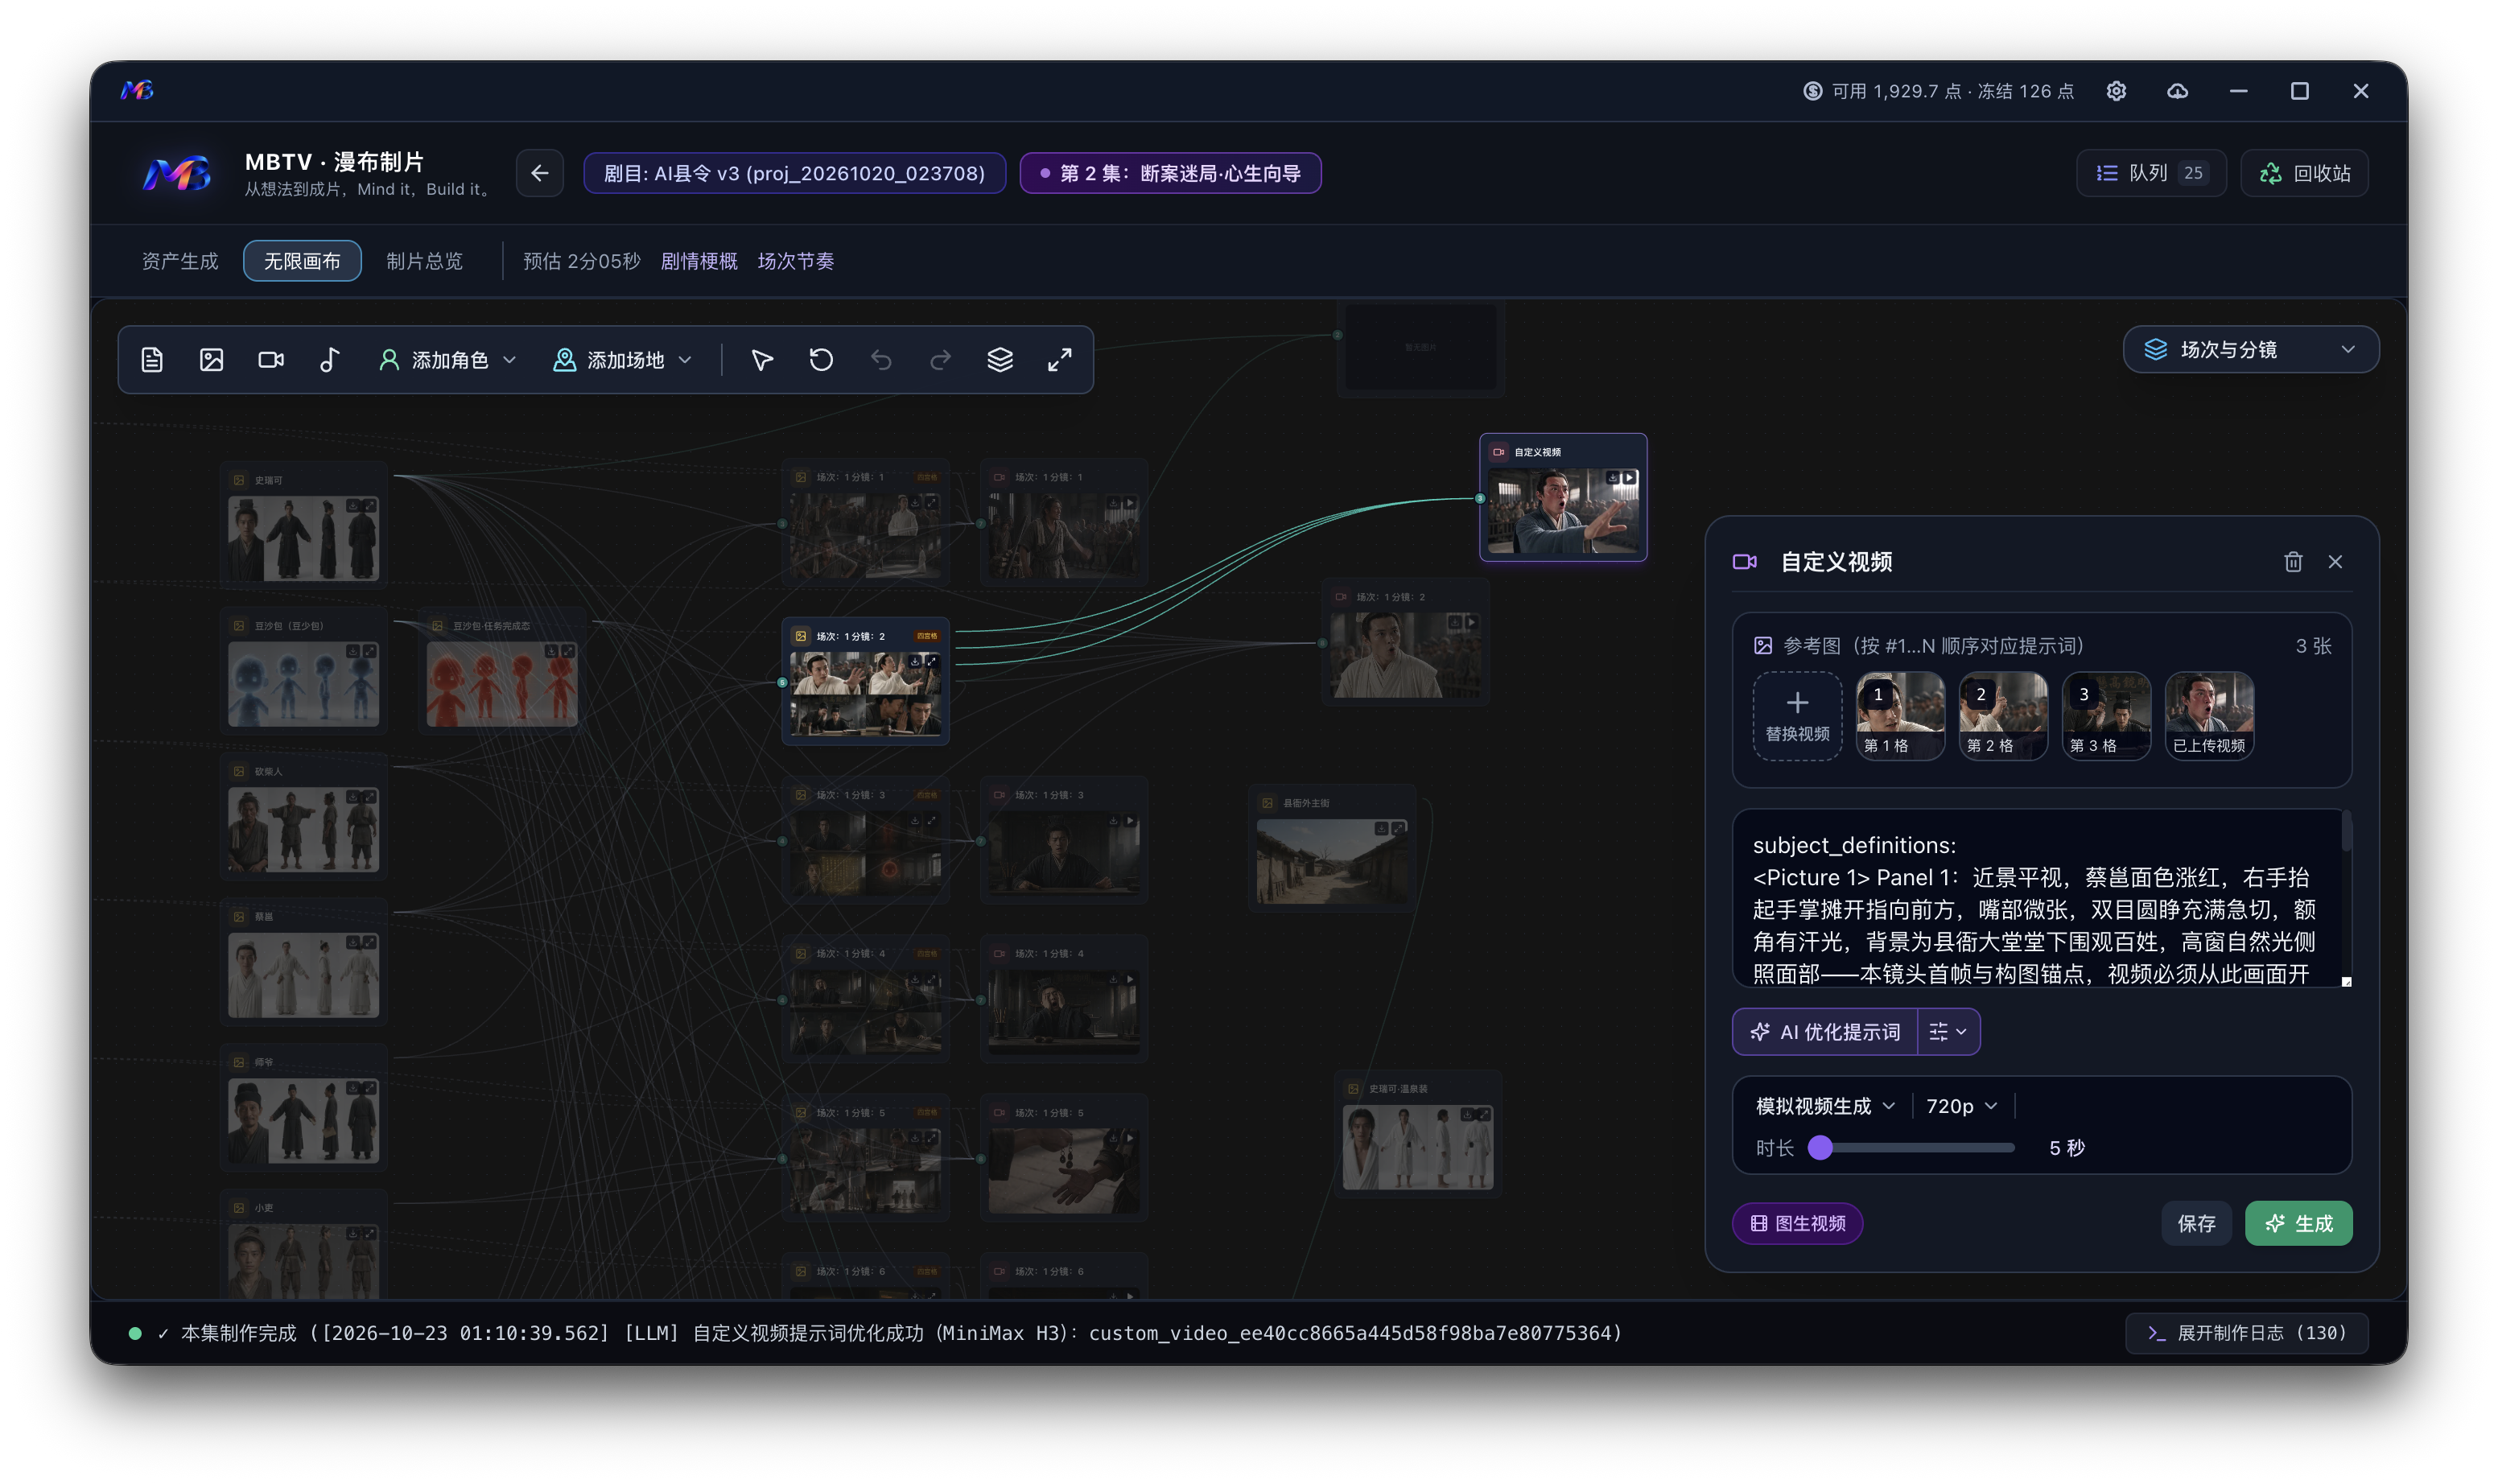
MBTV会输出AI工作流水线的每一步的中间数据,而不只是最终视频、图片以及提示词,你可以学习到AI制片过程中的所有提示词都是如何写出来的。
也不限制你必须使用MBTV去生成所有图片或视频,你可以拷贝MBTV生成的图片、视频生成提示词,去豆包、GPT等平台,用免费额度生成图片、视频片段后再回来继续下一步,不会一到关键步骤,就因为弹出订阅、充值而中断了学习过程。
每一个想做AI视频/短剧的新手,都是从碎片化的教程开始的,很少有人愿意直接上手所谓“一站式”平台,一是因为贵,二是因为啥也学不到。
点击平台上的一个热门流行模板,只要你愿意充钱,是快,但你除了能看到最终的十几秒或几分钟视频,心里空落落的……你啥也没介入,你只是一个旁观者,看着平台的工具、模板帮你完成一个和别人有点像的视频,离开了这个平台,你还是啥也不会。
想长期干的,大多经历过手搓的阶段,只有经历了手搓的痛苦,才会想要找工具来解决枯燥和繁琐的步骤(包括MBTV团队自己,几分钟视频手写几十上百条提示词太扯淡了,这一点也不AI,而且碎片化的文件管理也是个天坑)。
MBTV在开发过程中,始终保持AI做的每个步骤工作的开放性,AI的工作过程和产出:可观察、可学习。
不会写剧本?
你能学习MBTV是怎样使唤AI编写出剧本的(当然,你也可以直接扔小说或故事给豆包、GPT改编剧本,实际效果你可以输出来和MBTV导出的剧本进行对比,看区别在哪里)。
通过搜索剧本的关键词和网络热点、流行风向,目标受众
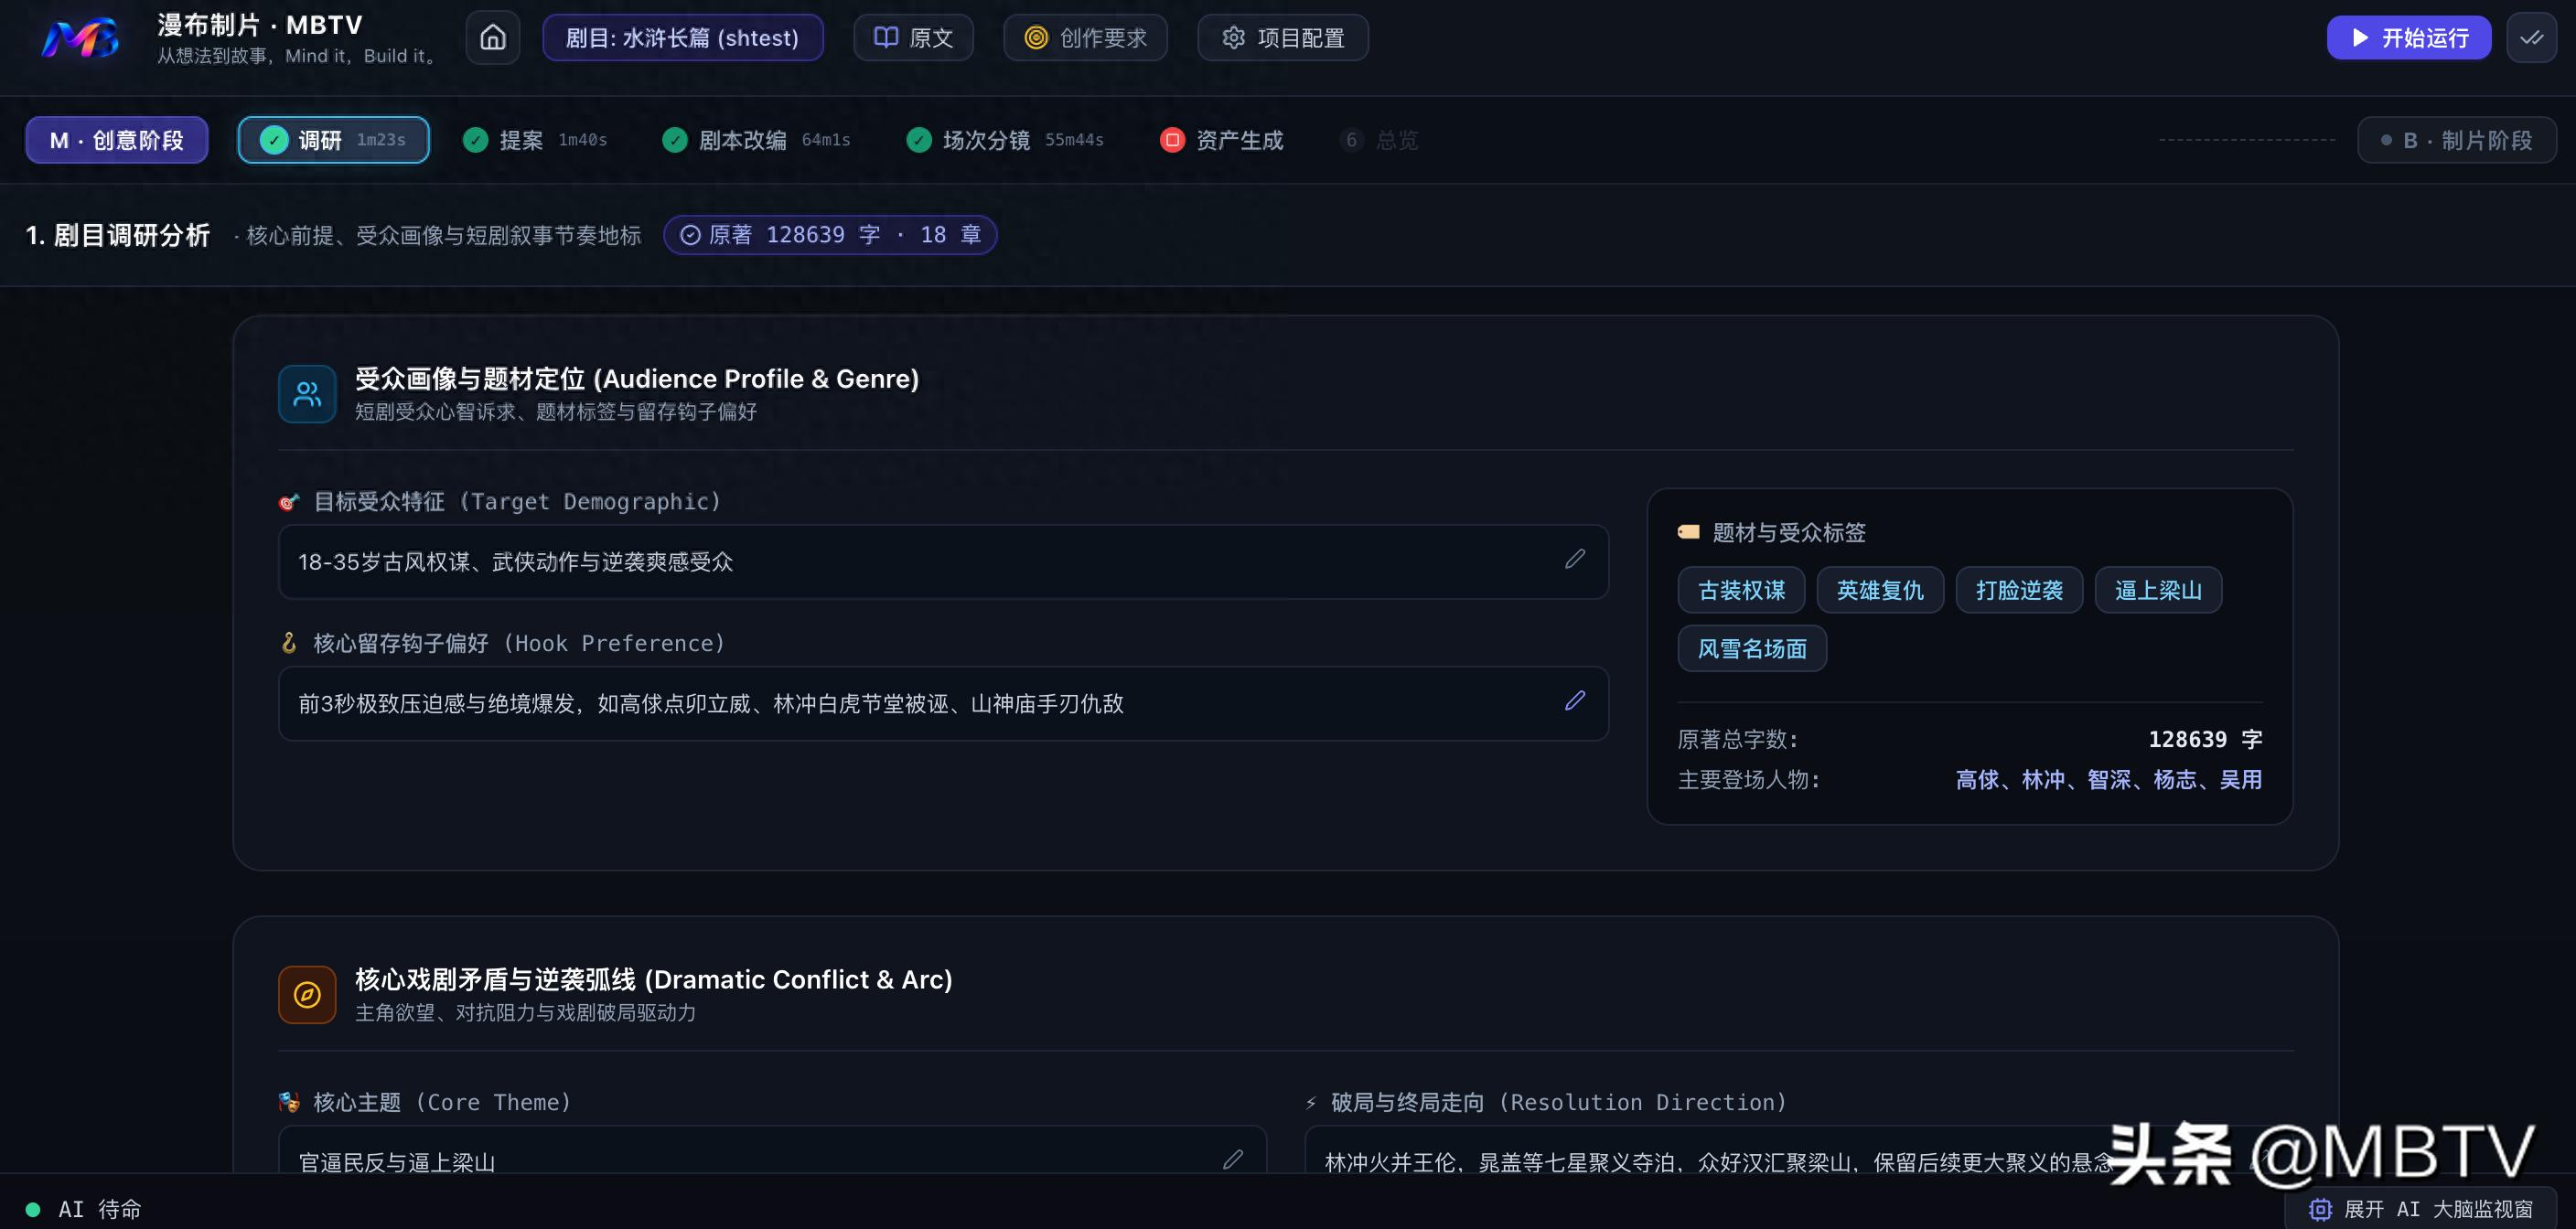
设定短剧市场需求的剧情短平快、开场反转等节奏叙事
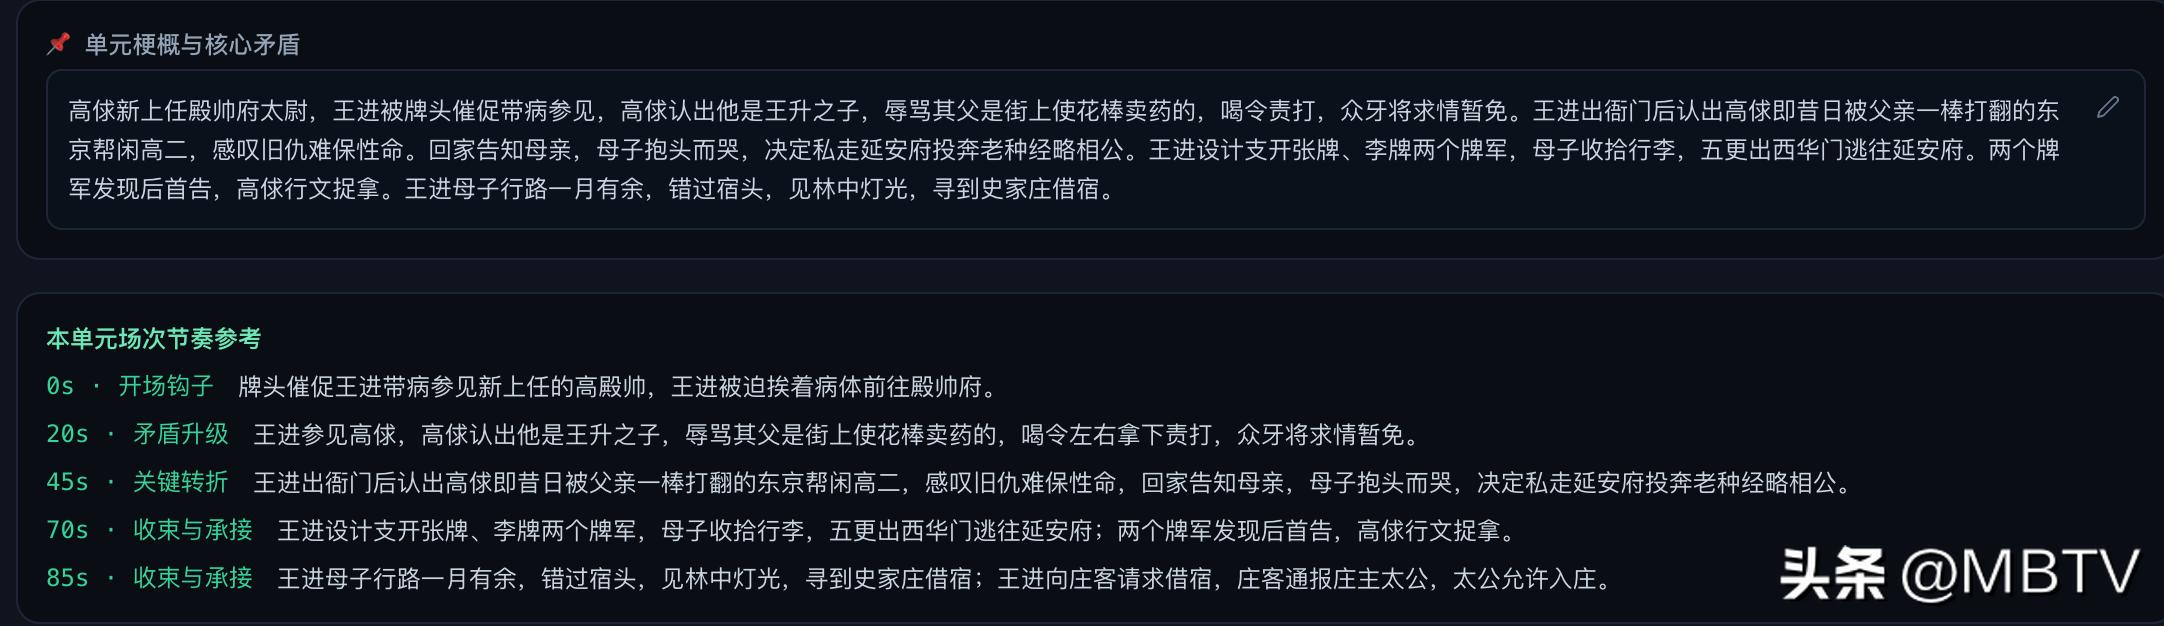
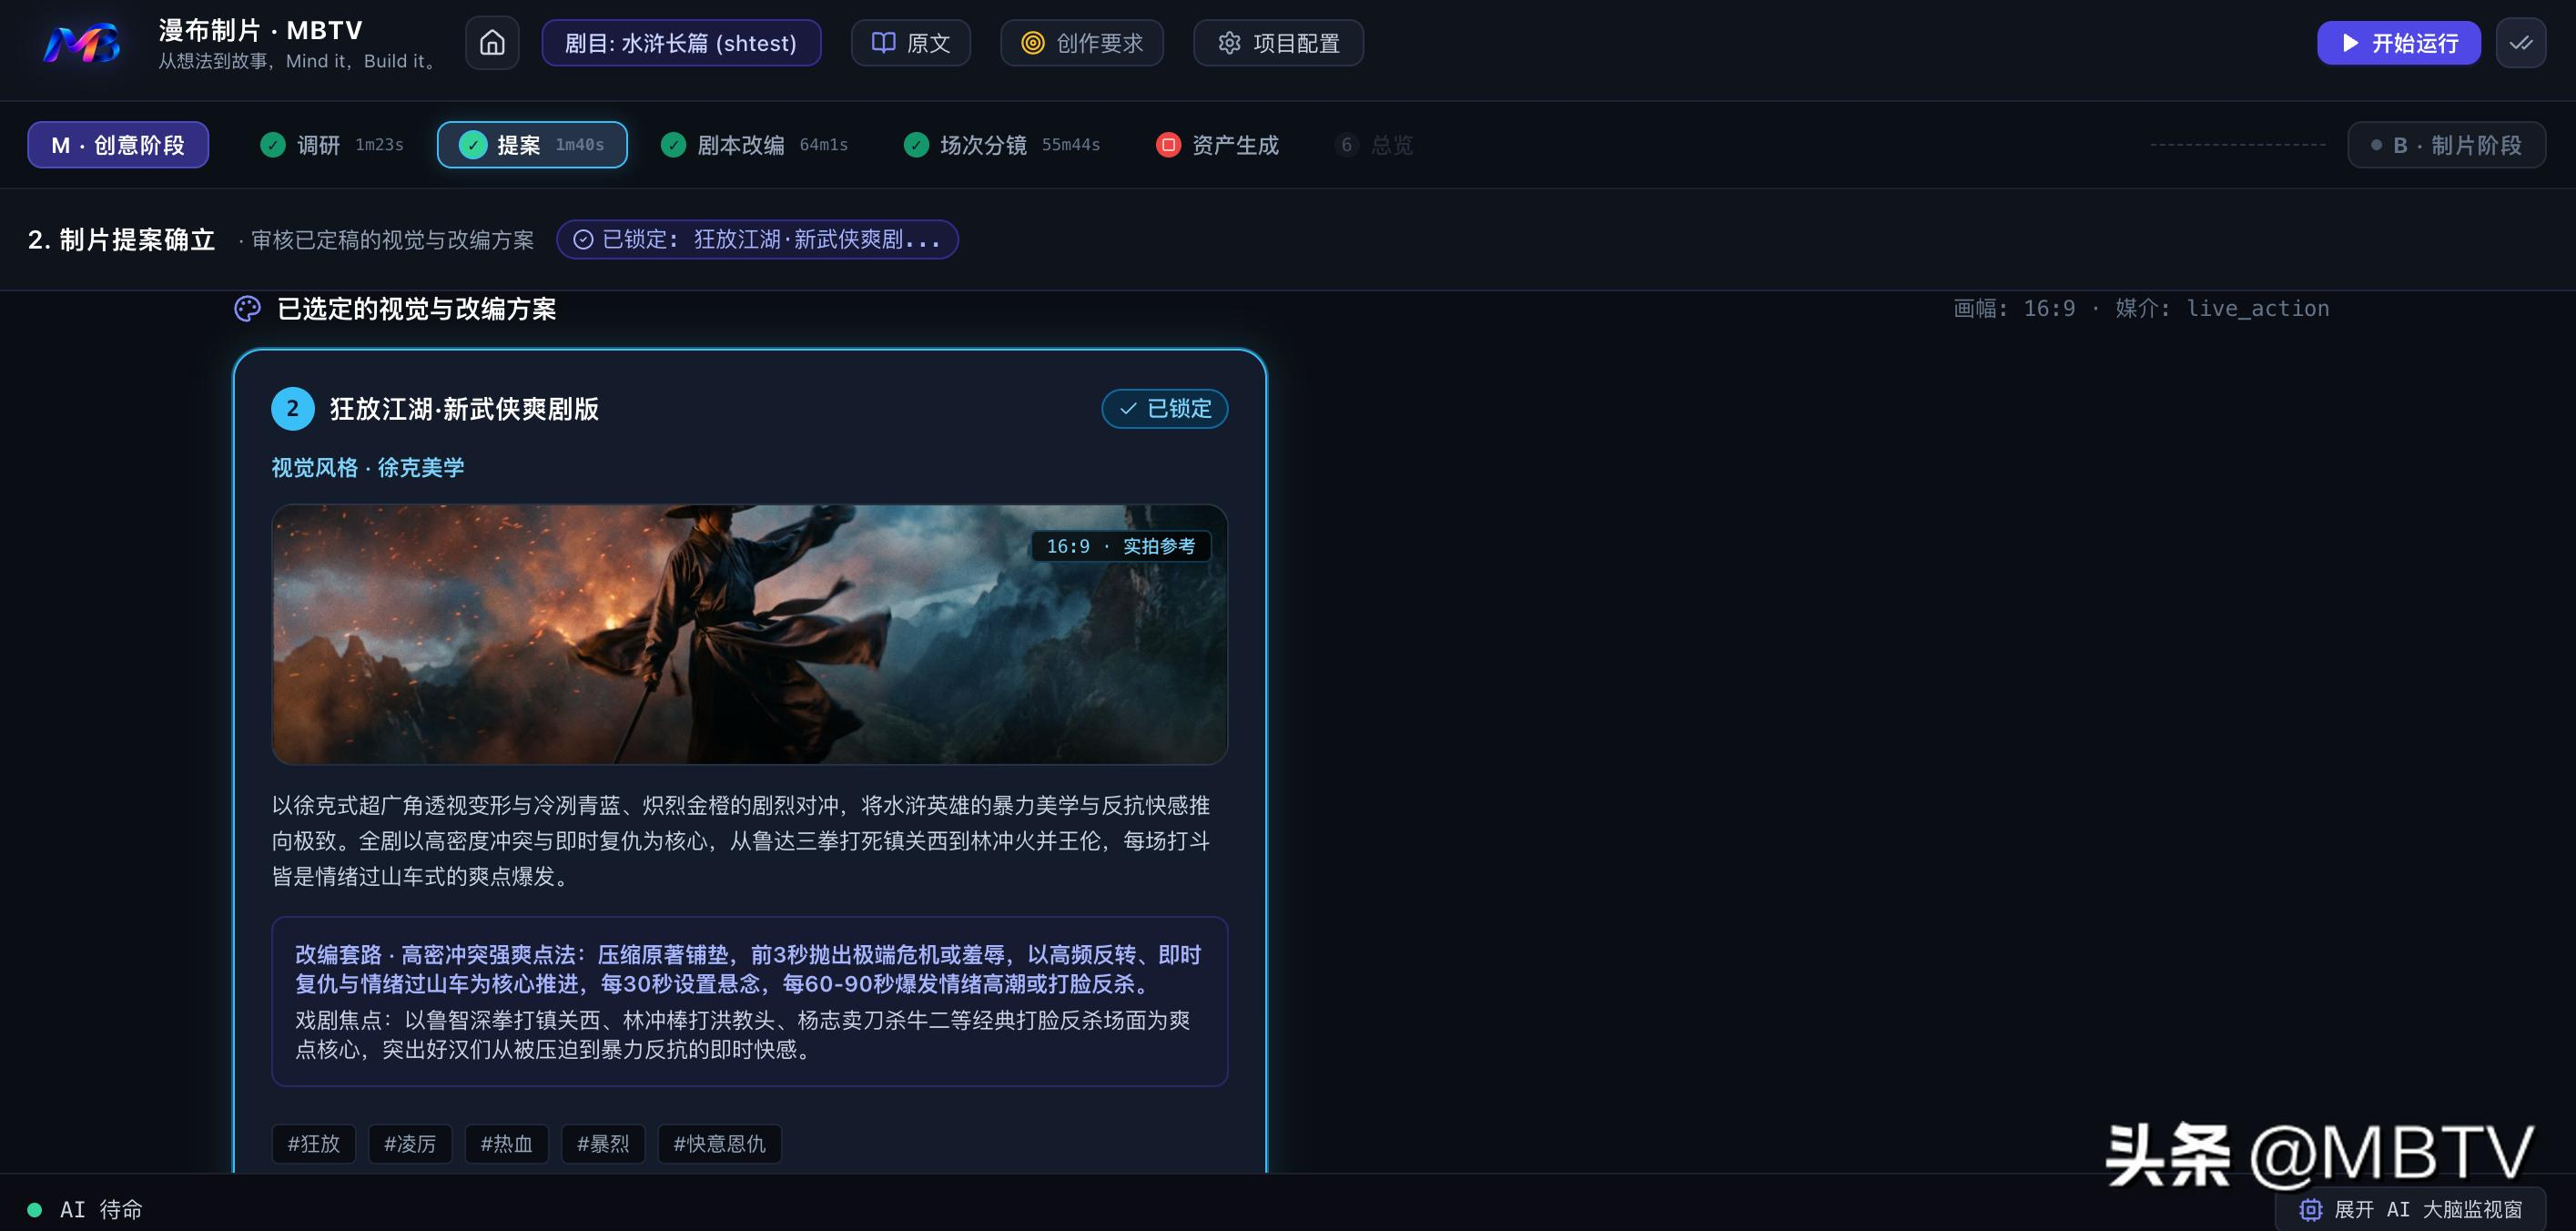
选定更受市场欢迎的剧本改编套路和视觉风格
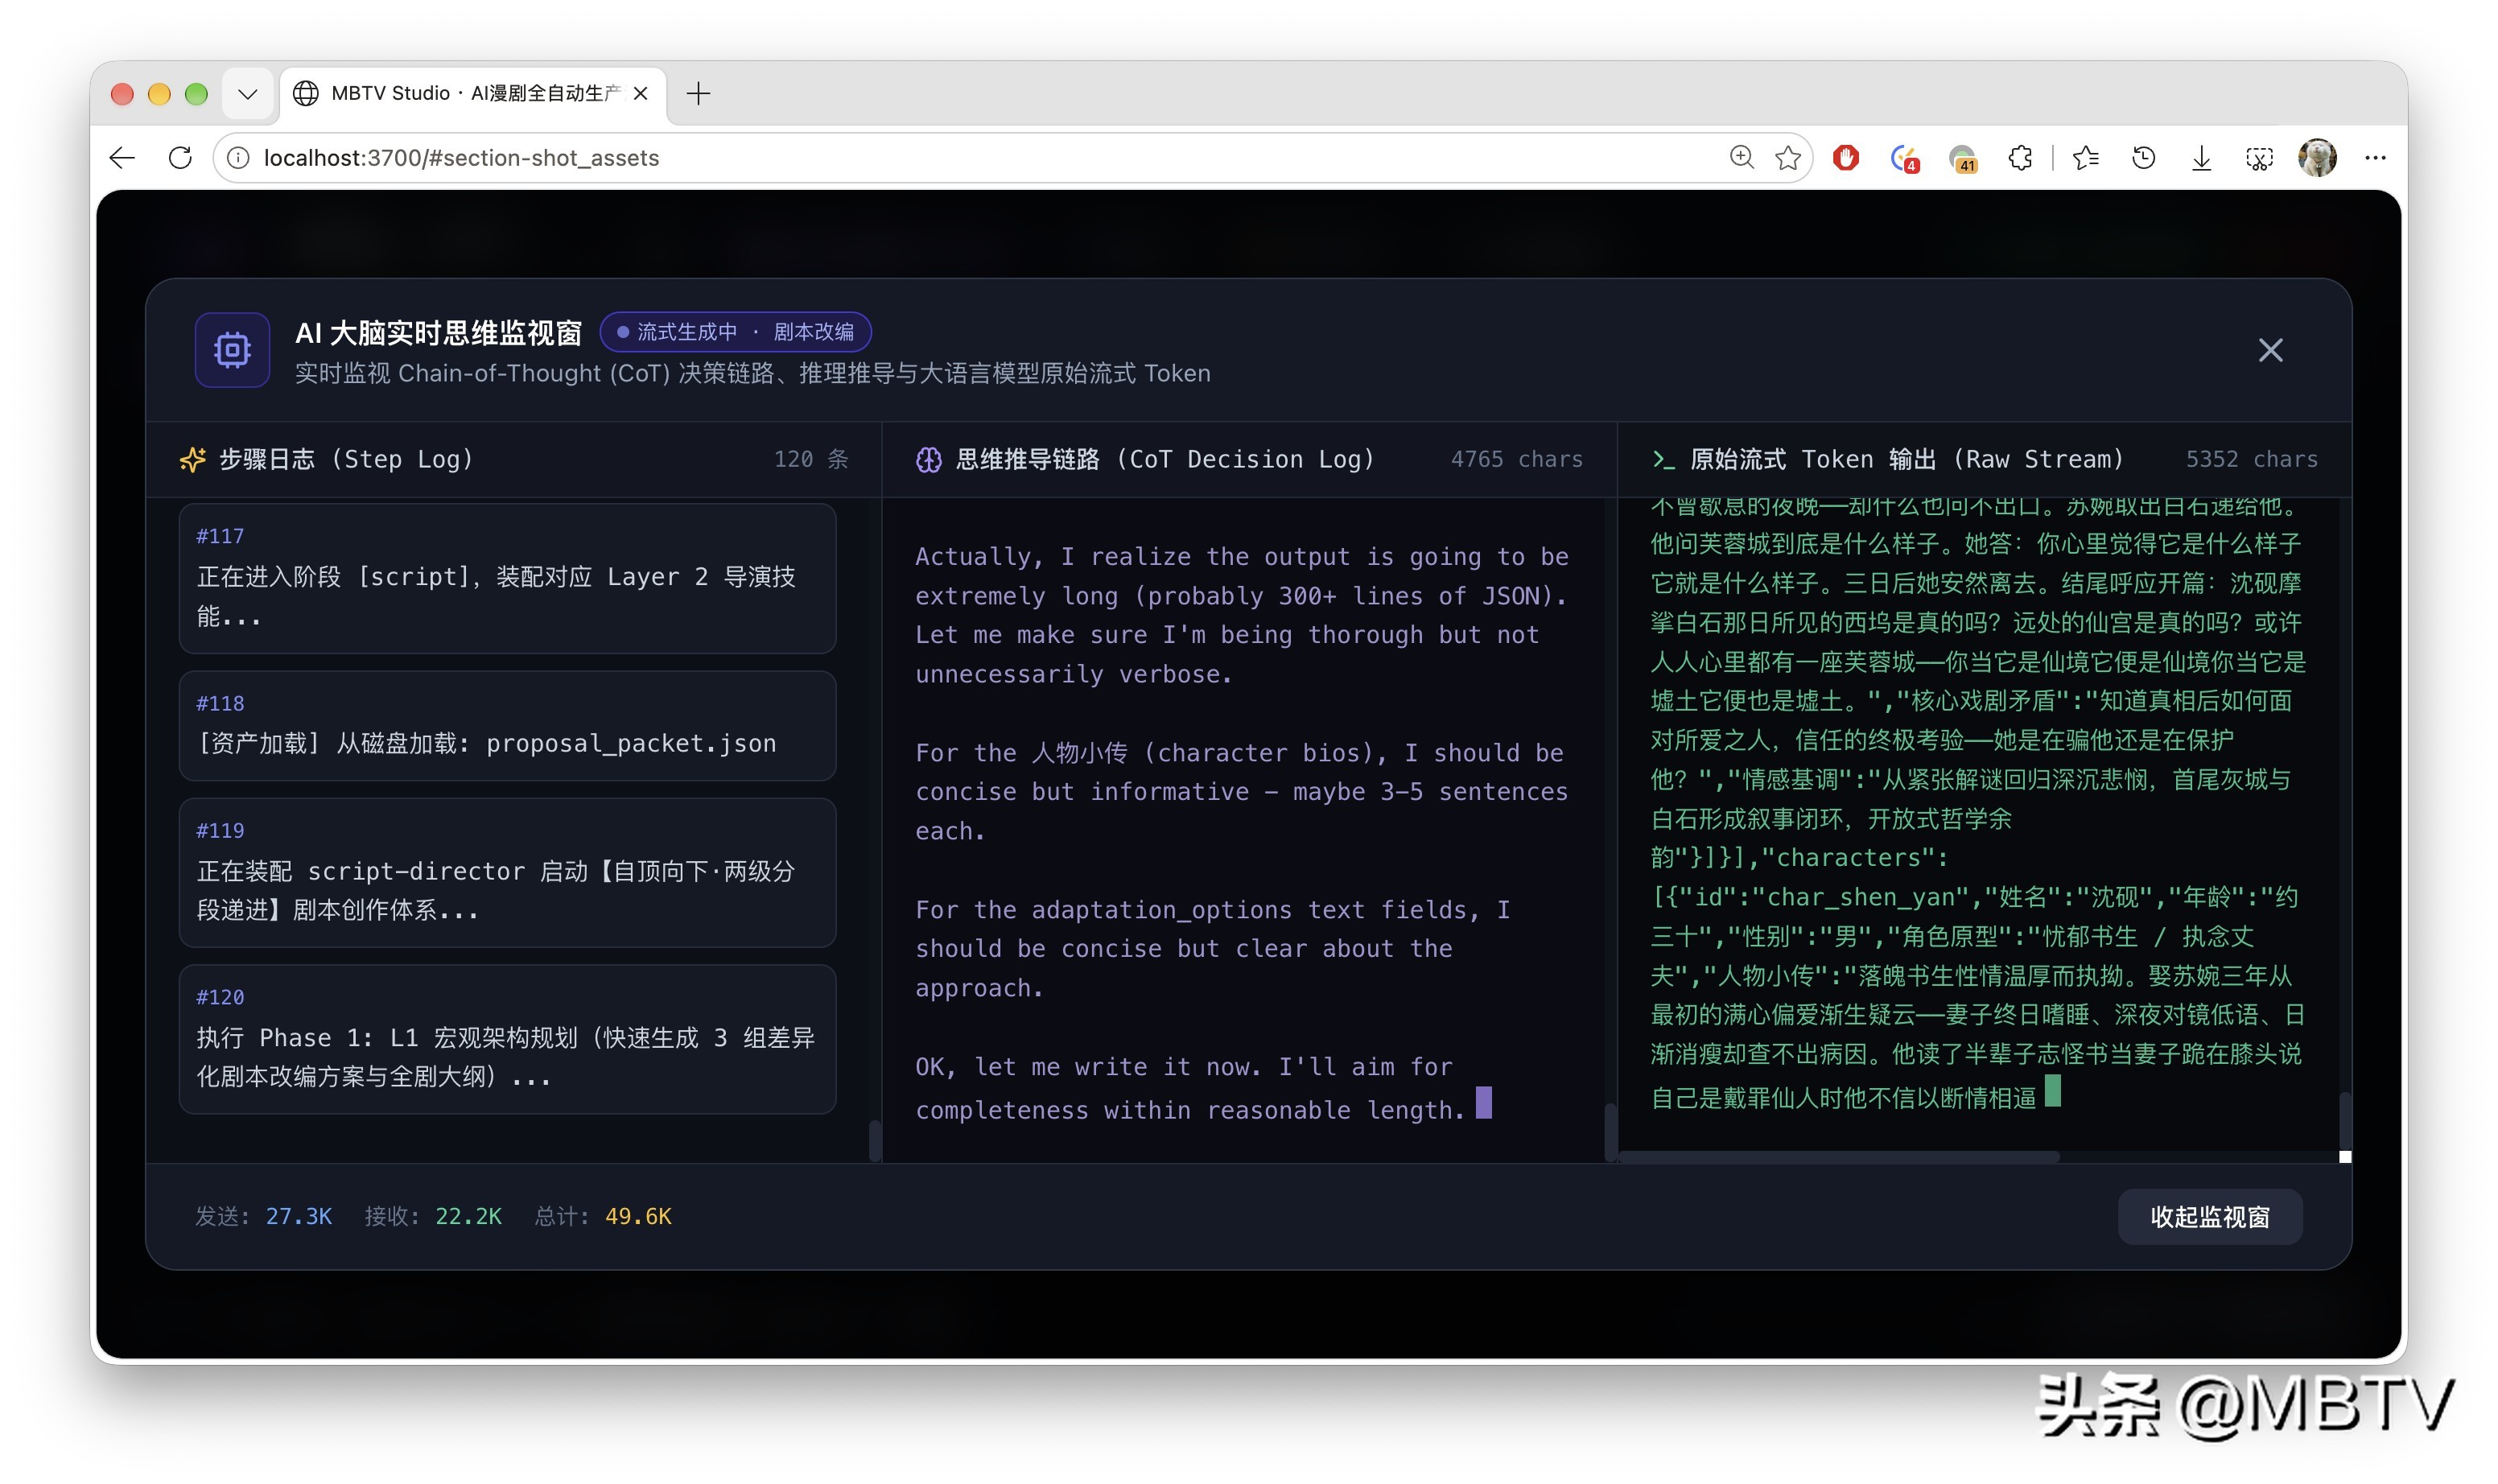
打开AI大脑思维日志,你也能看到AI思考的每一步
角色和场景设定
目前AI的原理决定了要保持人物和场景的一致性,一定要生成角色和场景设定参考图,并且是越细越好,不然没有记忆的AI会每次生成的内容完全不相关。
生成什么样的角色和场景,好不好看都是各种画风、化妆、服饰提示词共同作用的结果,新手可以从MBTV的视觉风格设定页面了解到AI是如何定视觉风格: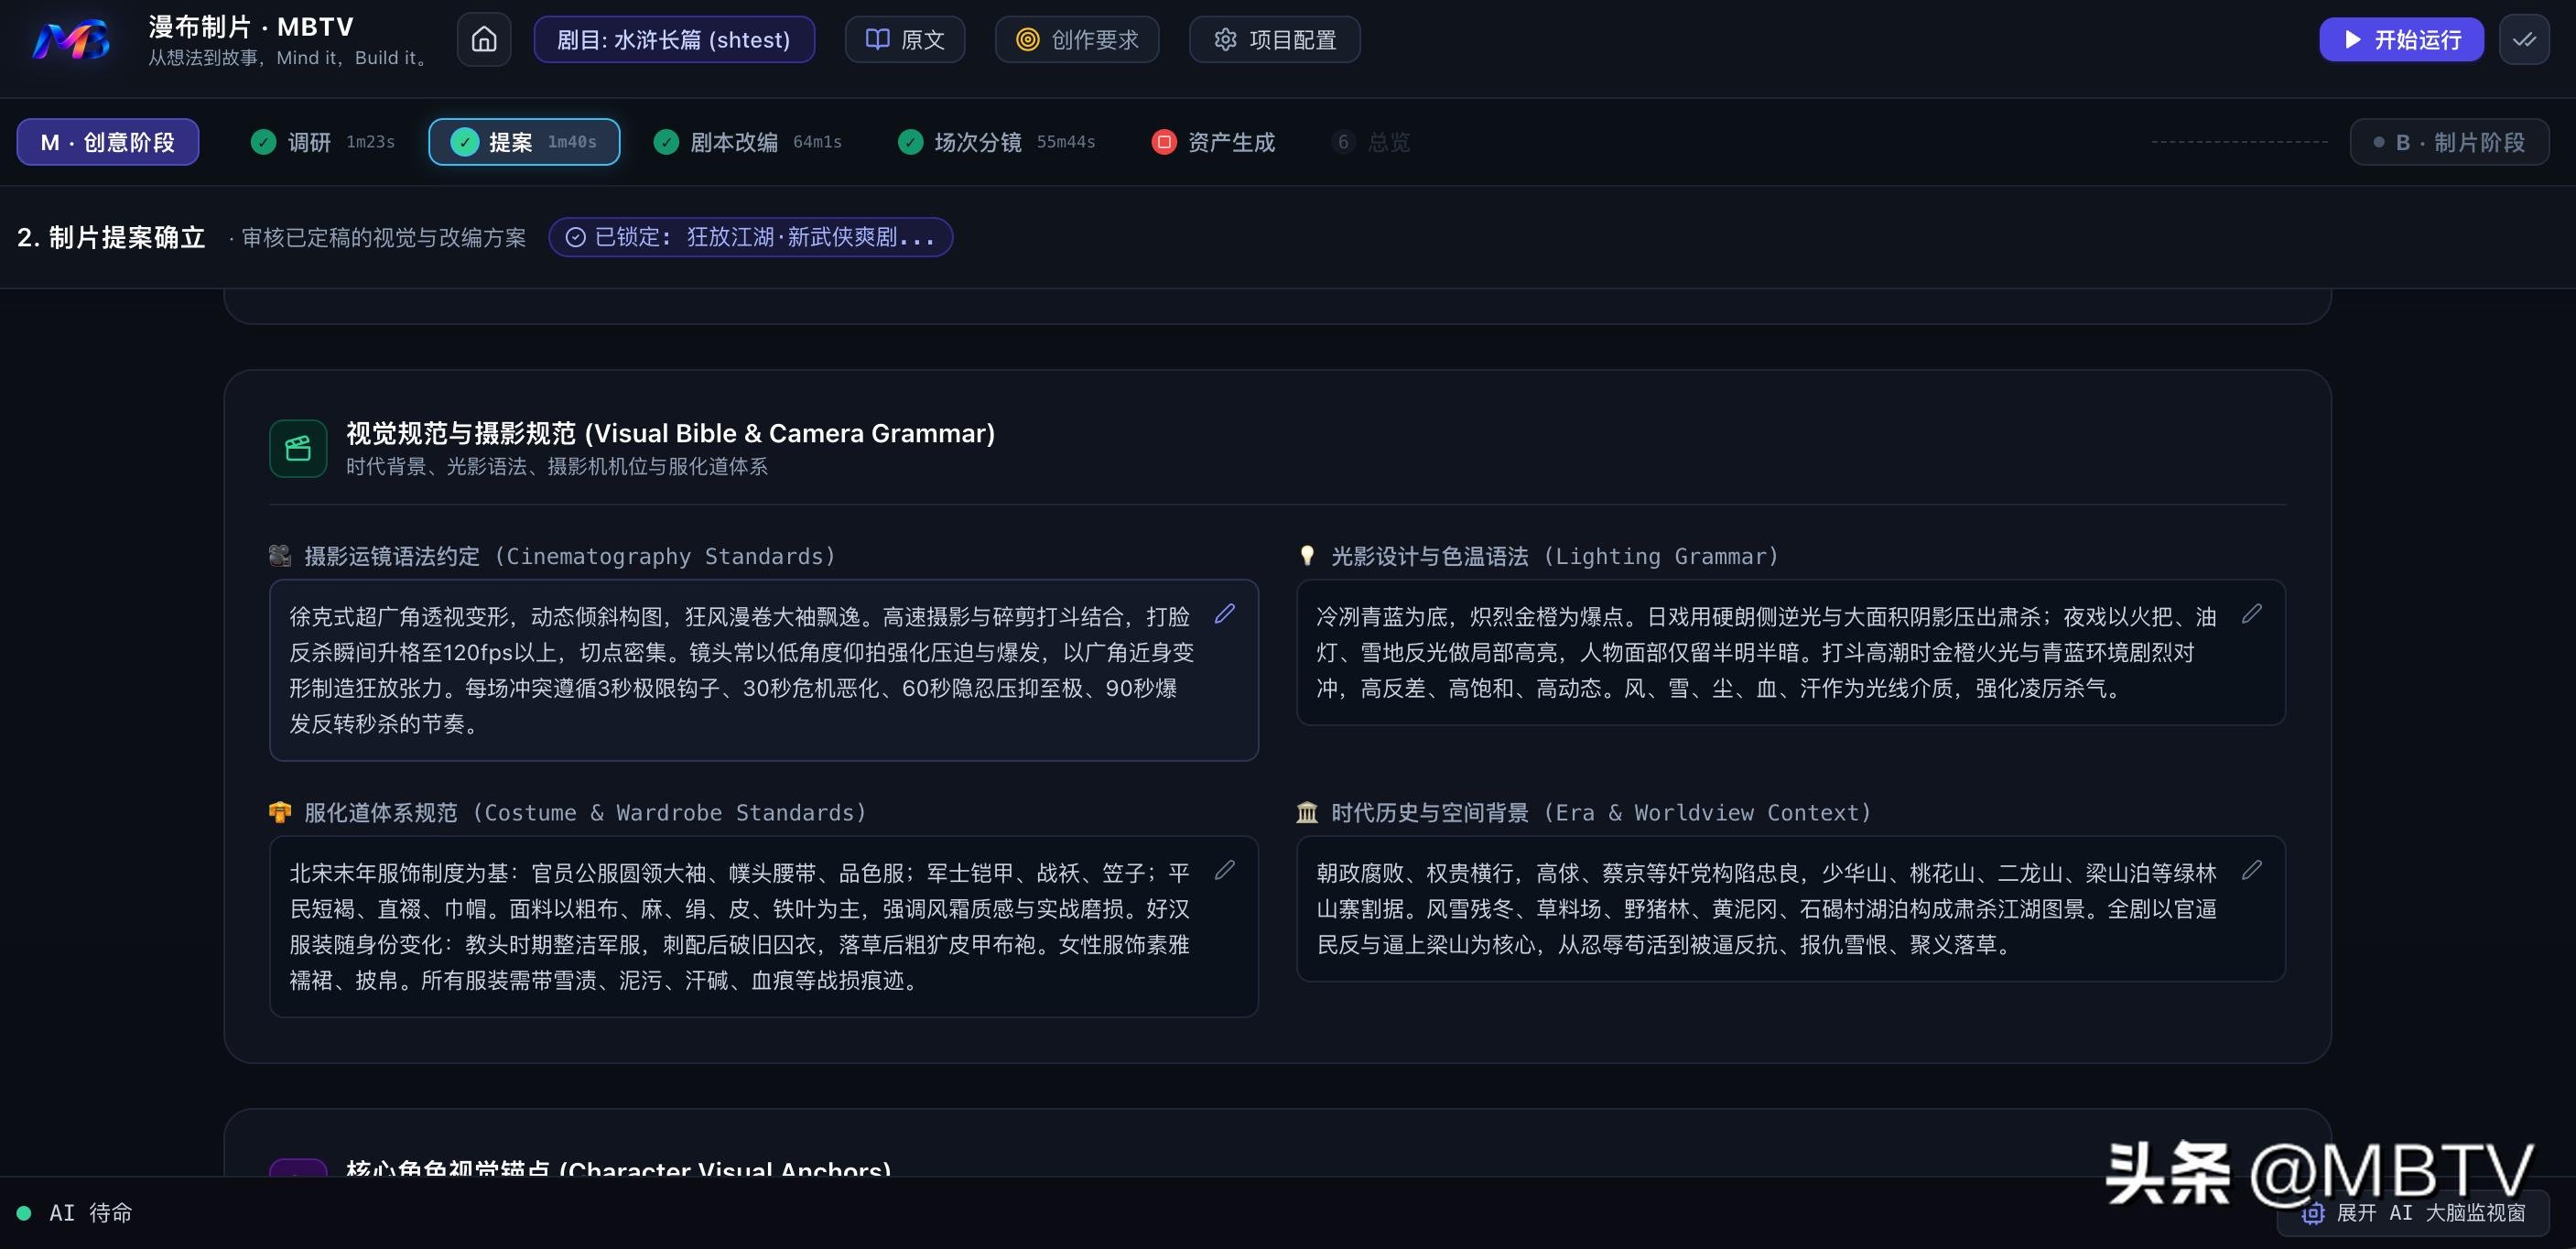
如何定人物造型和场景布景的: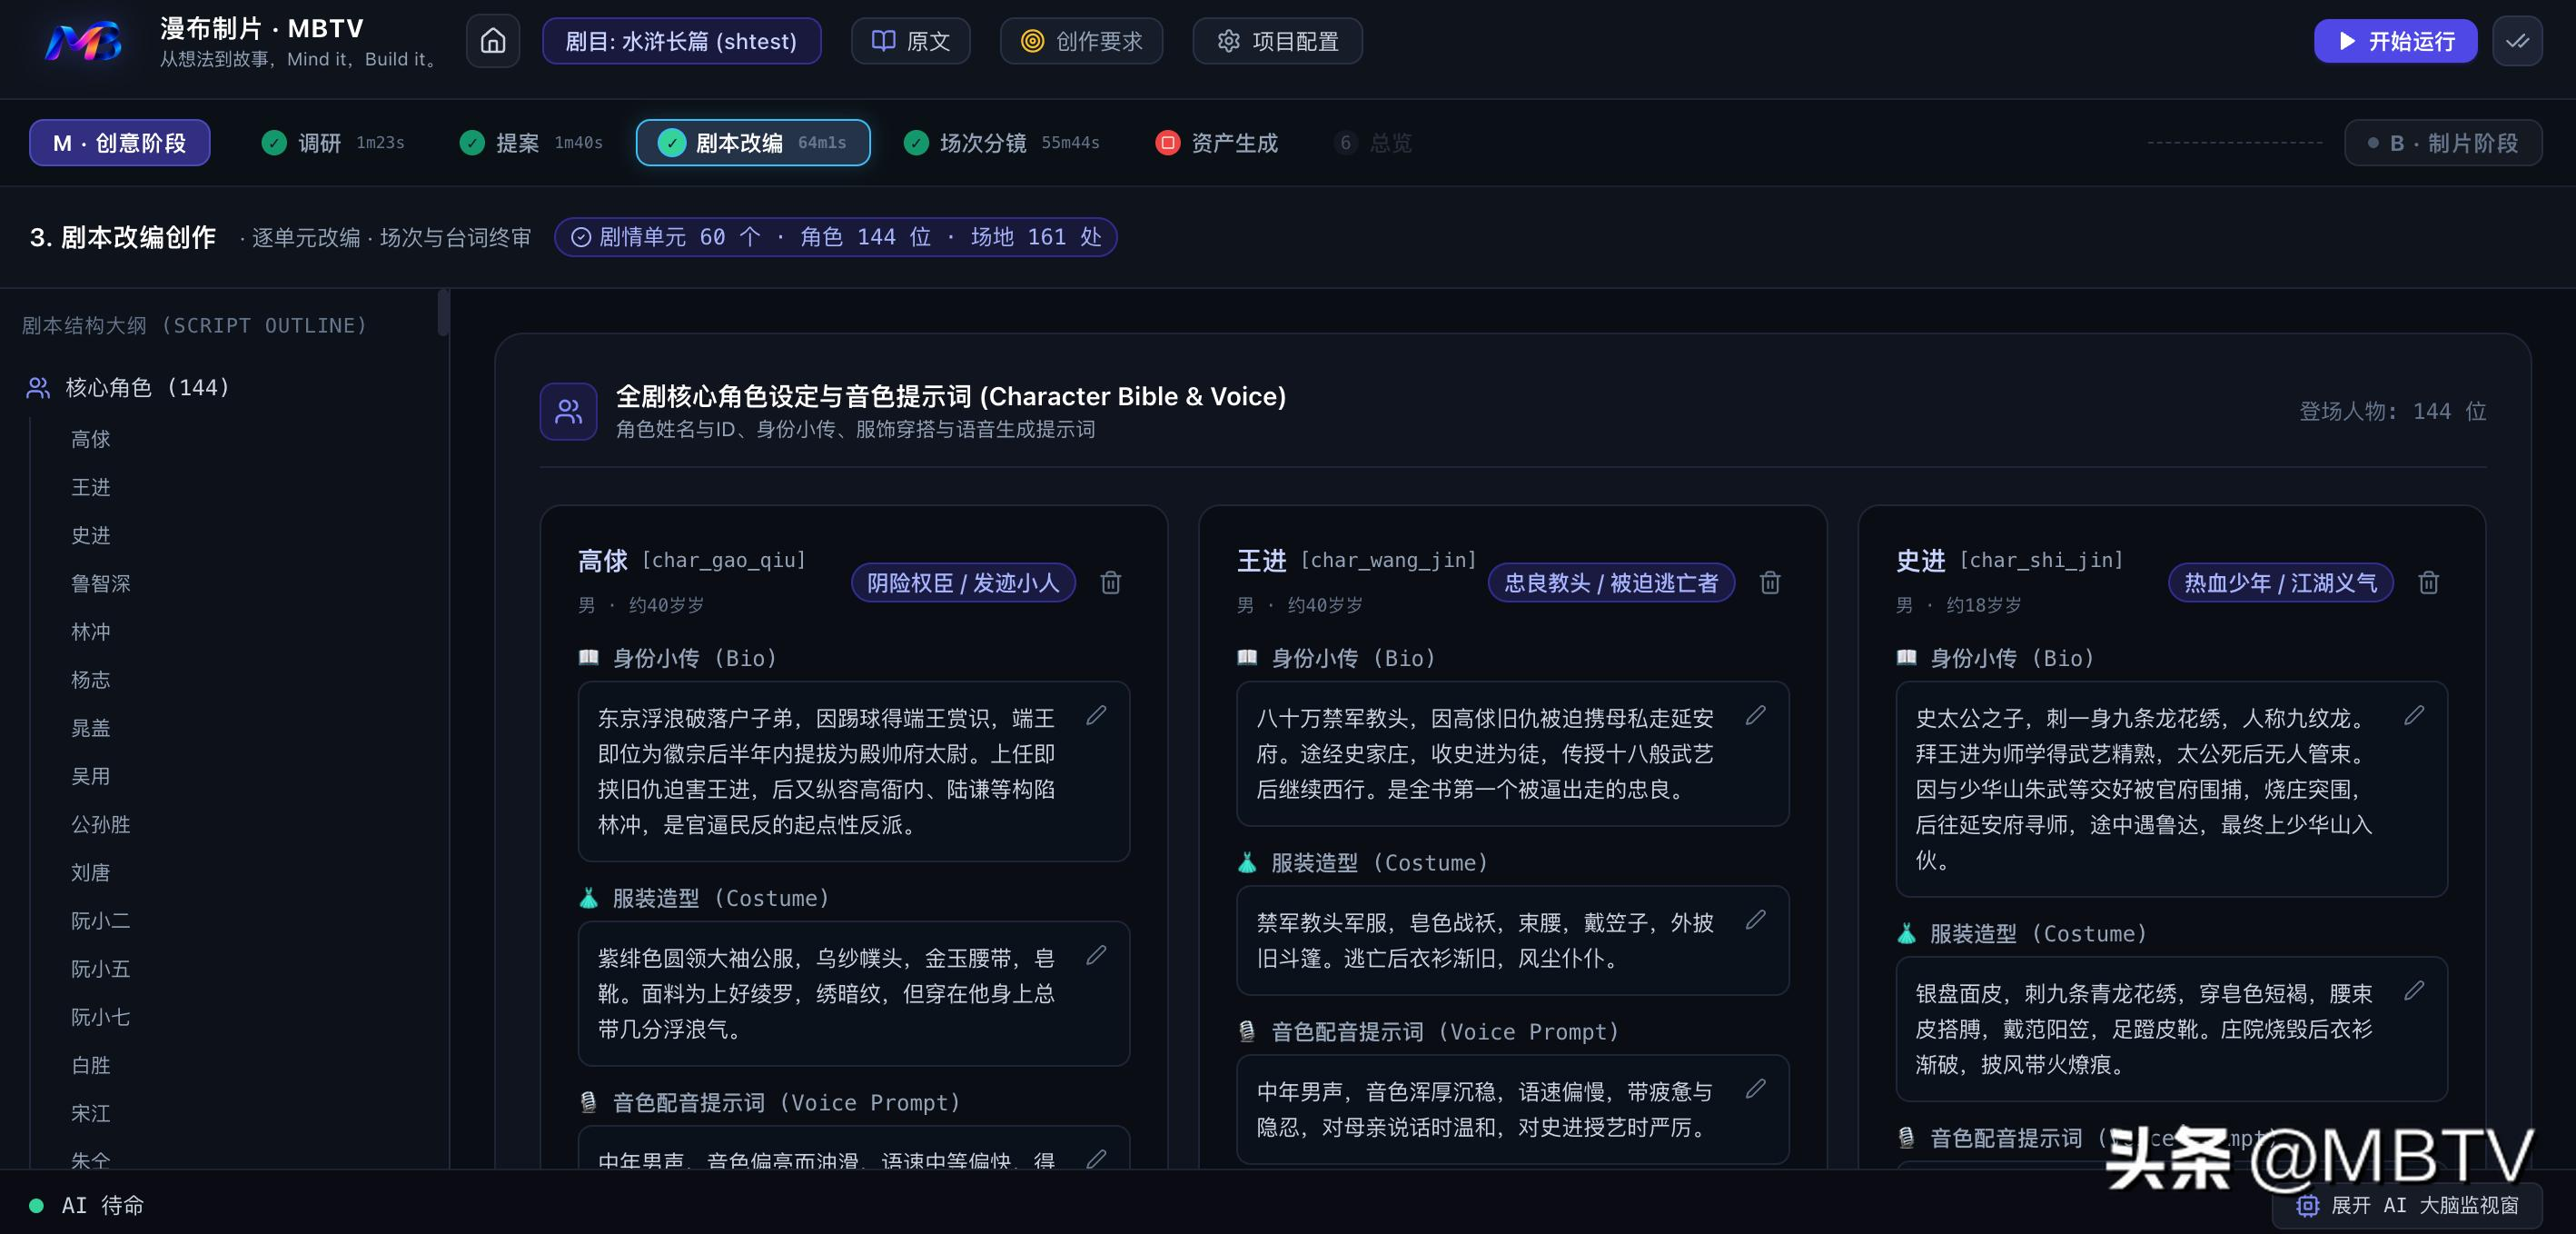
然后完全可以自行用这些信息去问豆包、问GPT,让它们同样生成人物场景设定图,和MBTV最后输出的人物四视图的文生图提示词对比看区别在哪,知道提示词到底是从何而来的: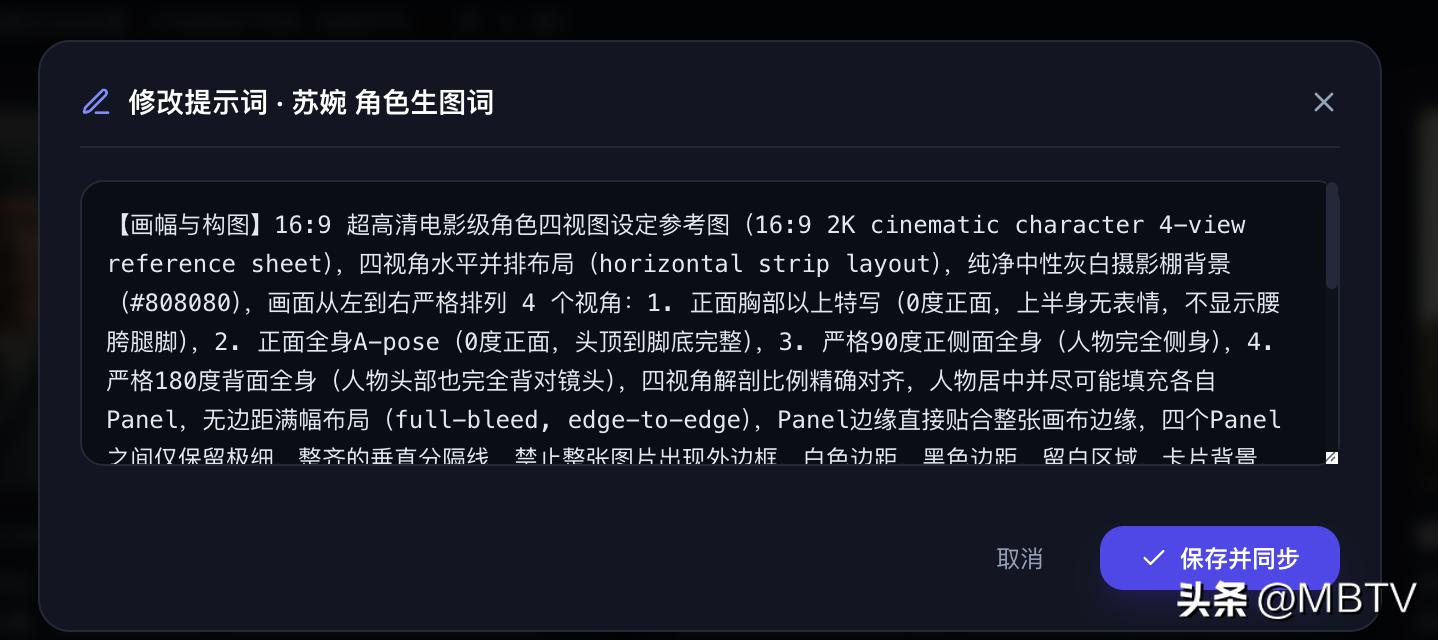
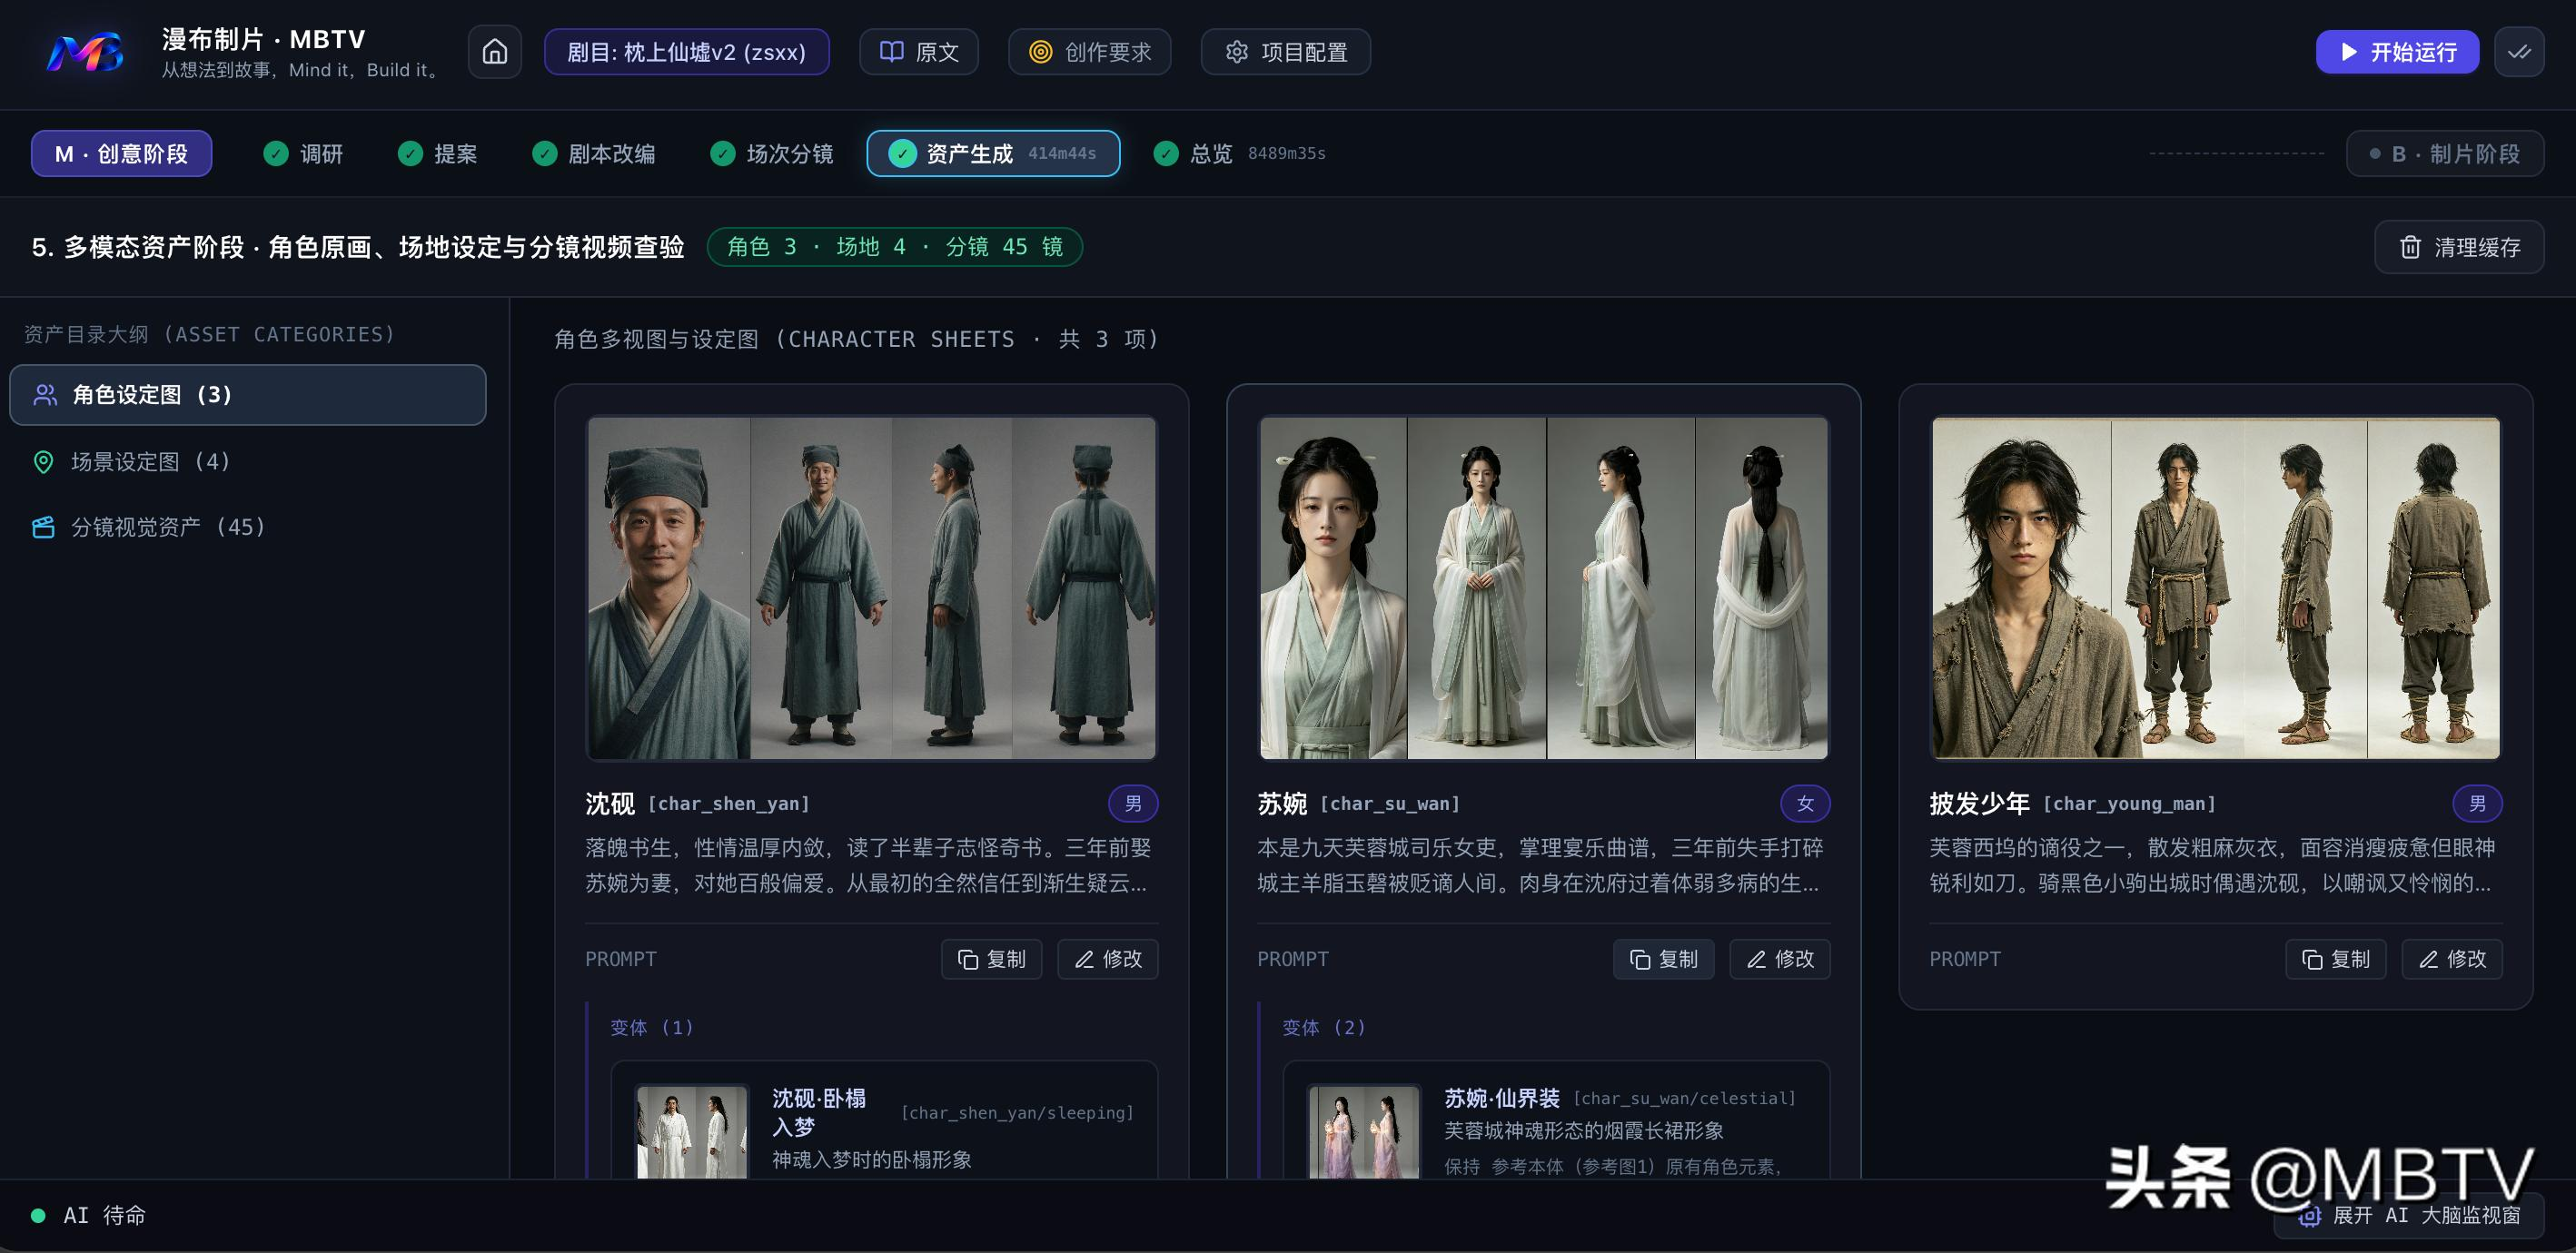
有了提示词,你可以去豆包、GPT或Gemini等平台用免费额度生成你的角色和场景,学习阶段不用花费。
你也可以把其它平台生成的角色和场景图片,再上传到MBTV平台上继续下一步学习。
分场和分镜
这里其实也有许多流派,有写小作文的,拿到剧本,直接就给Seedance写一段千字长文开始视频制作,描述每个时间段要生成什么画面,甚至ComfyUI里也有工作流追求循环生成长视频,这都是“小作文”流派。
这要求对视频生成模型非常熟悉,并且小作文也是严格针对某个模型来写的,生成的效果也是完全不确定的,就是开盲盒。
新手与这种做法基本无缘,你完全看不懂作者发出来的小作文为什么这么写,并且这也会随着模型的版本升级或未来你换模型而作废。
更保守,或者更学院派、更影视行业工业级的方法,是要做严格的剧本拆分,要拆分每集的场次和场次下的分镜,这是把剧本的剧情描述文字,转成影视作品的画面描述文字的过程,这样才能让视频生成模型准确地知道你要求的视频里每个时间点的画面是什么样子的,而不是猜。
分镜脚本里,一般会包含地点(对应场景参考图),出场人物(对应角色参考图),环境音效,台词等内容,以及一些摄像的专业术语:景别和视角,摄像机位。
这些都从头开始学的话,几乎是要重新上一遍电影学院导演课,许多人坚持不了。
但在AI时代,可以在AI的基础上学习,对照着它给的参考值和最终输出的画面效果,学起来事半功倍。
完全不学的话也可以,始终依赖AI写分镜可以出及格线上的成片,但肯定出不了有个人风格的作品。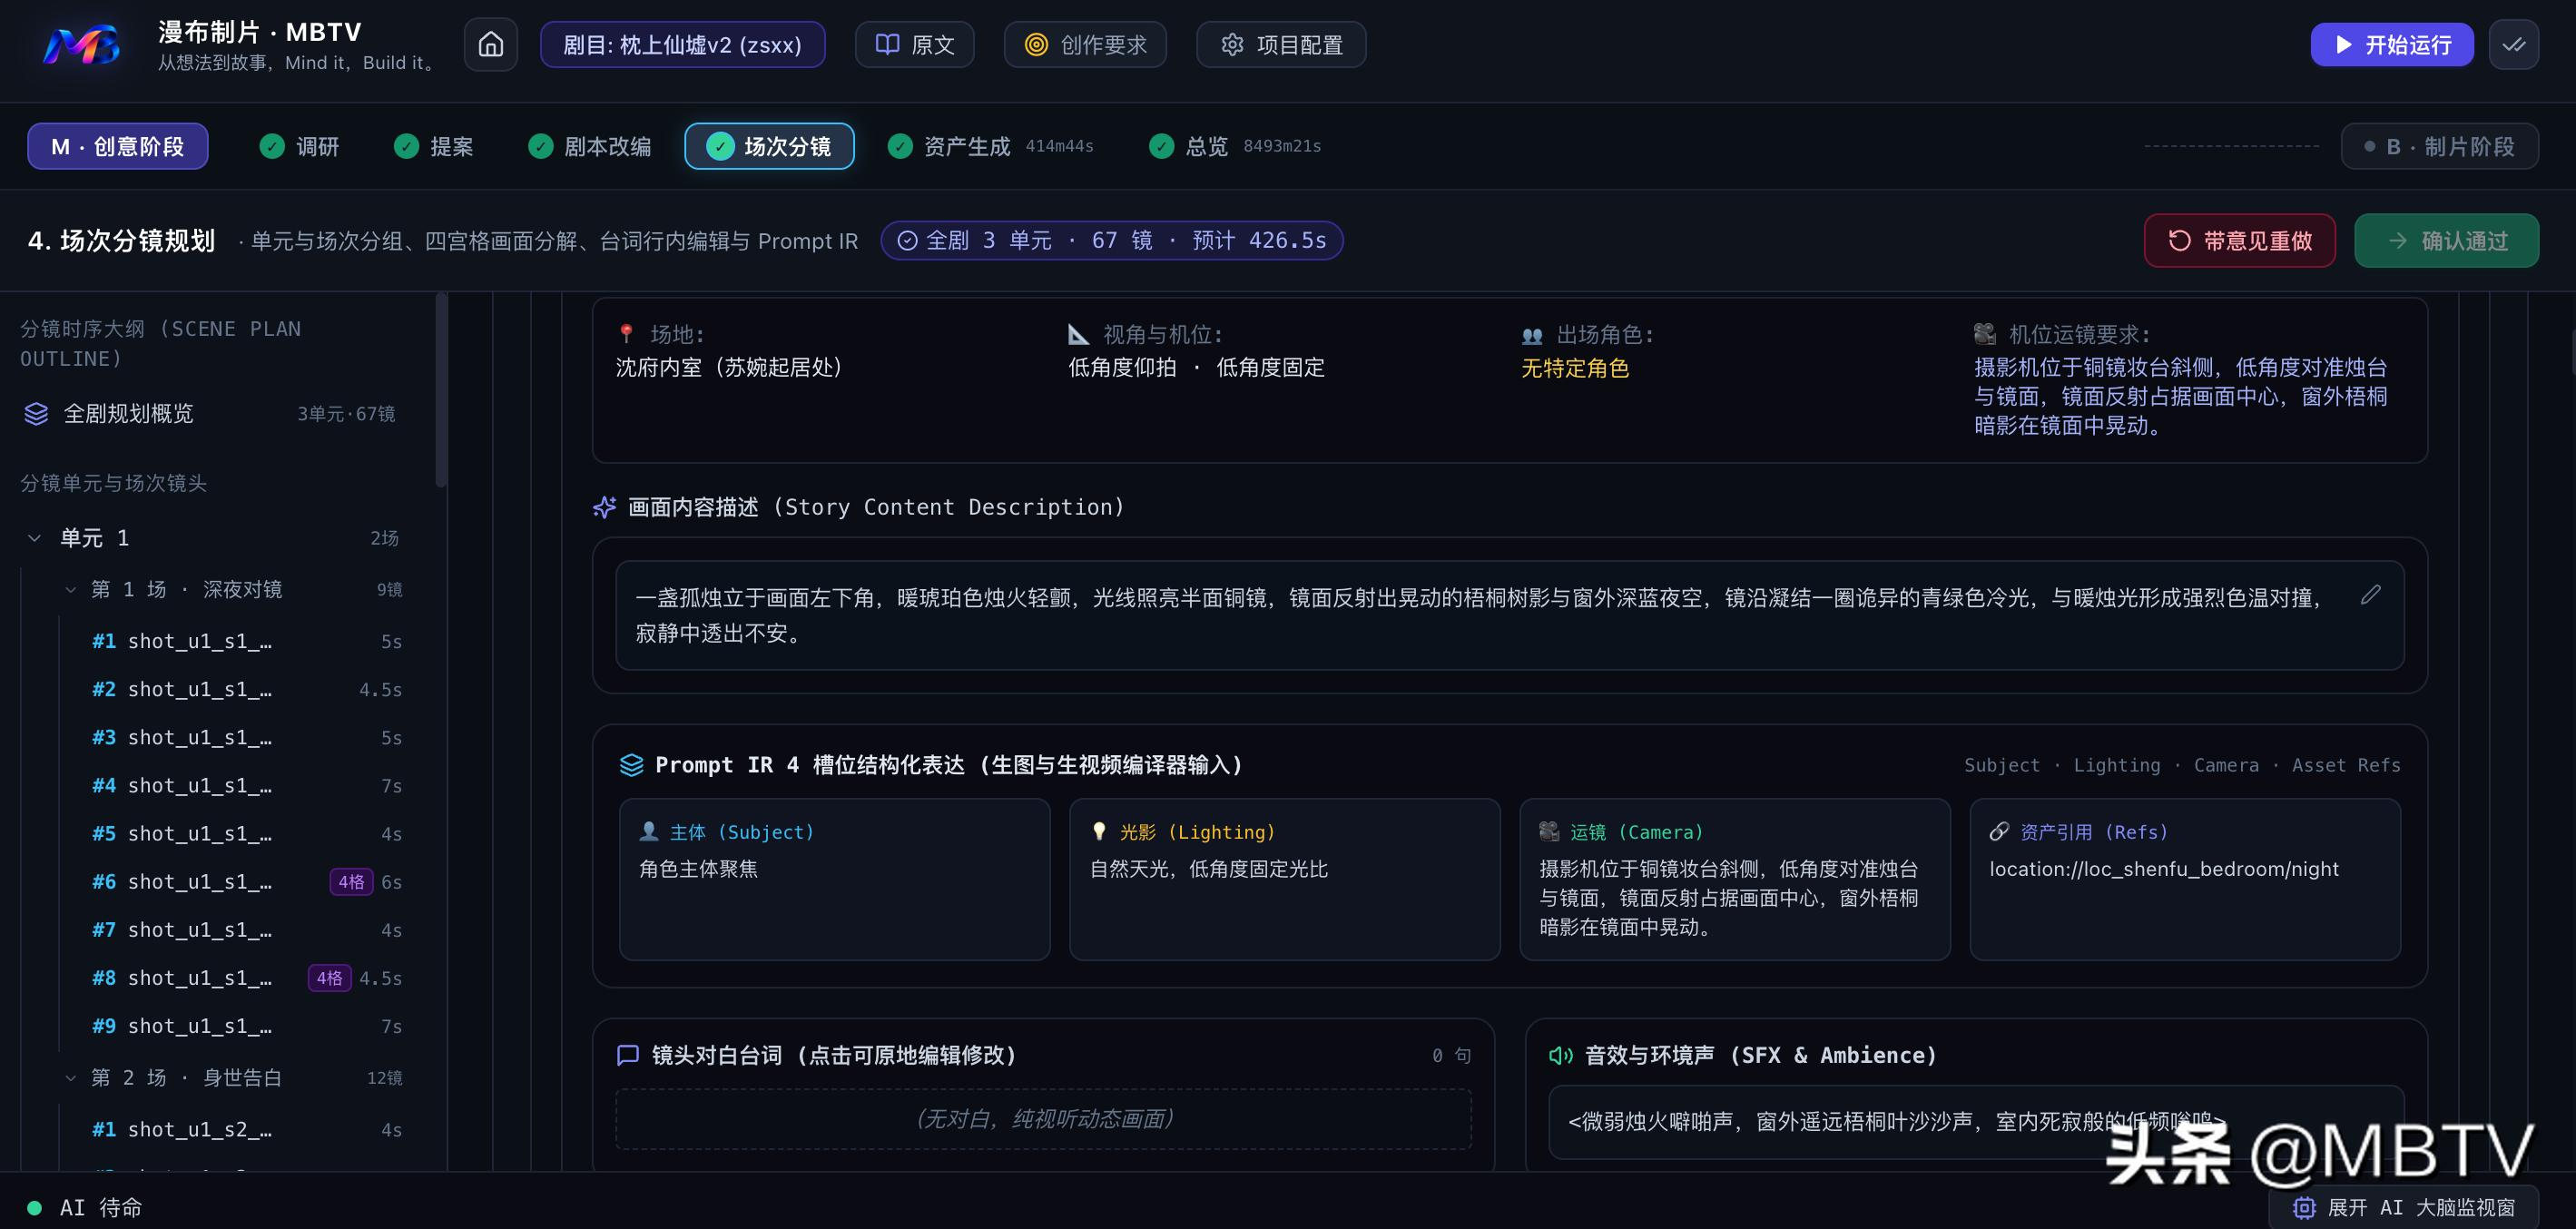
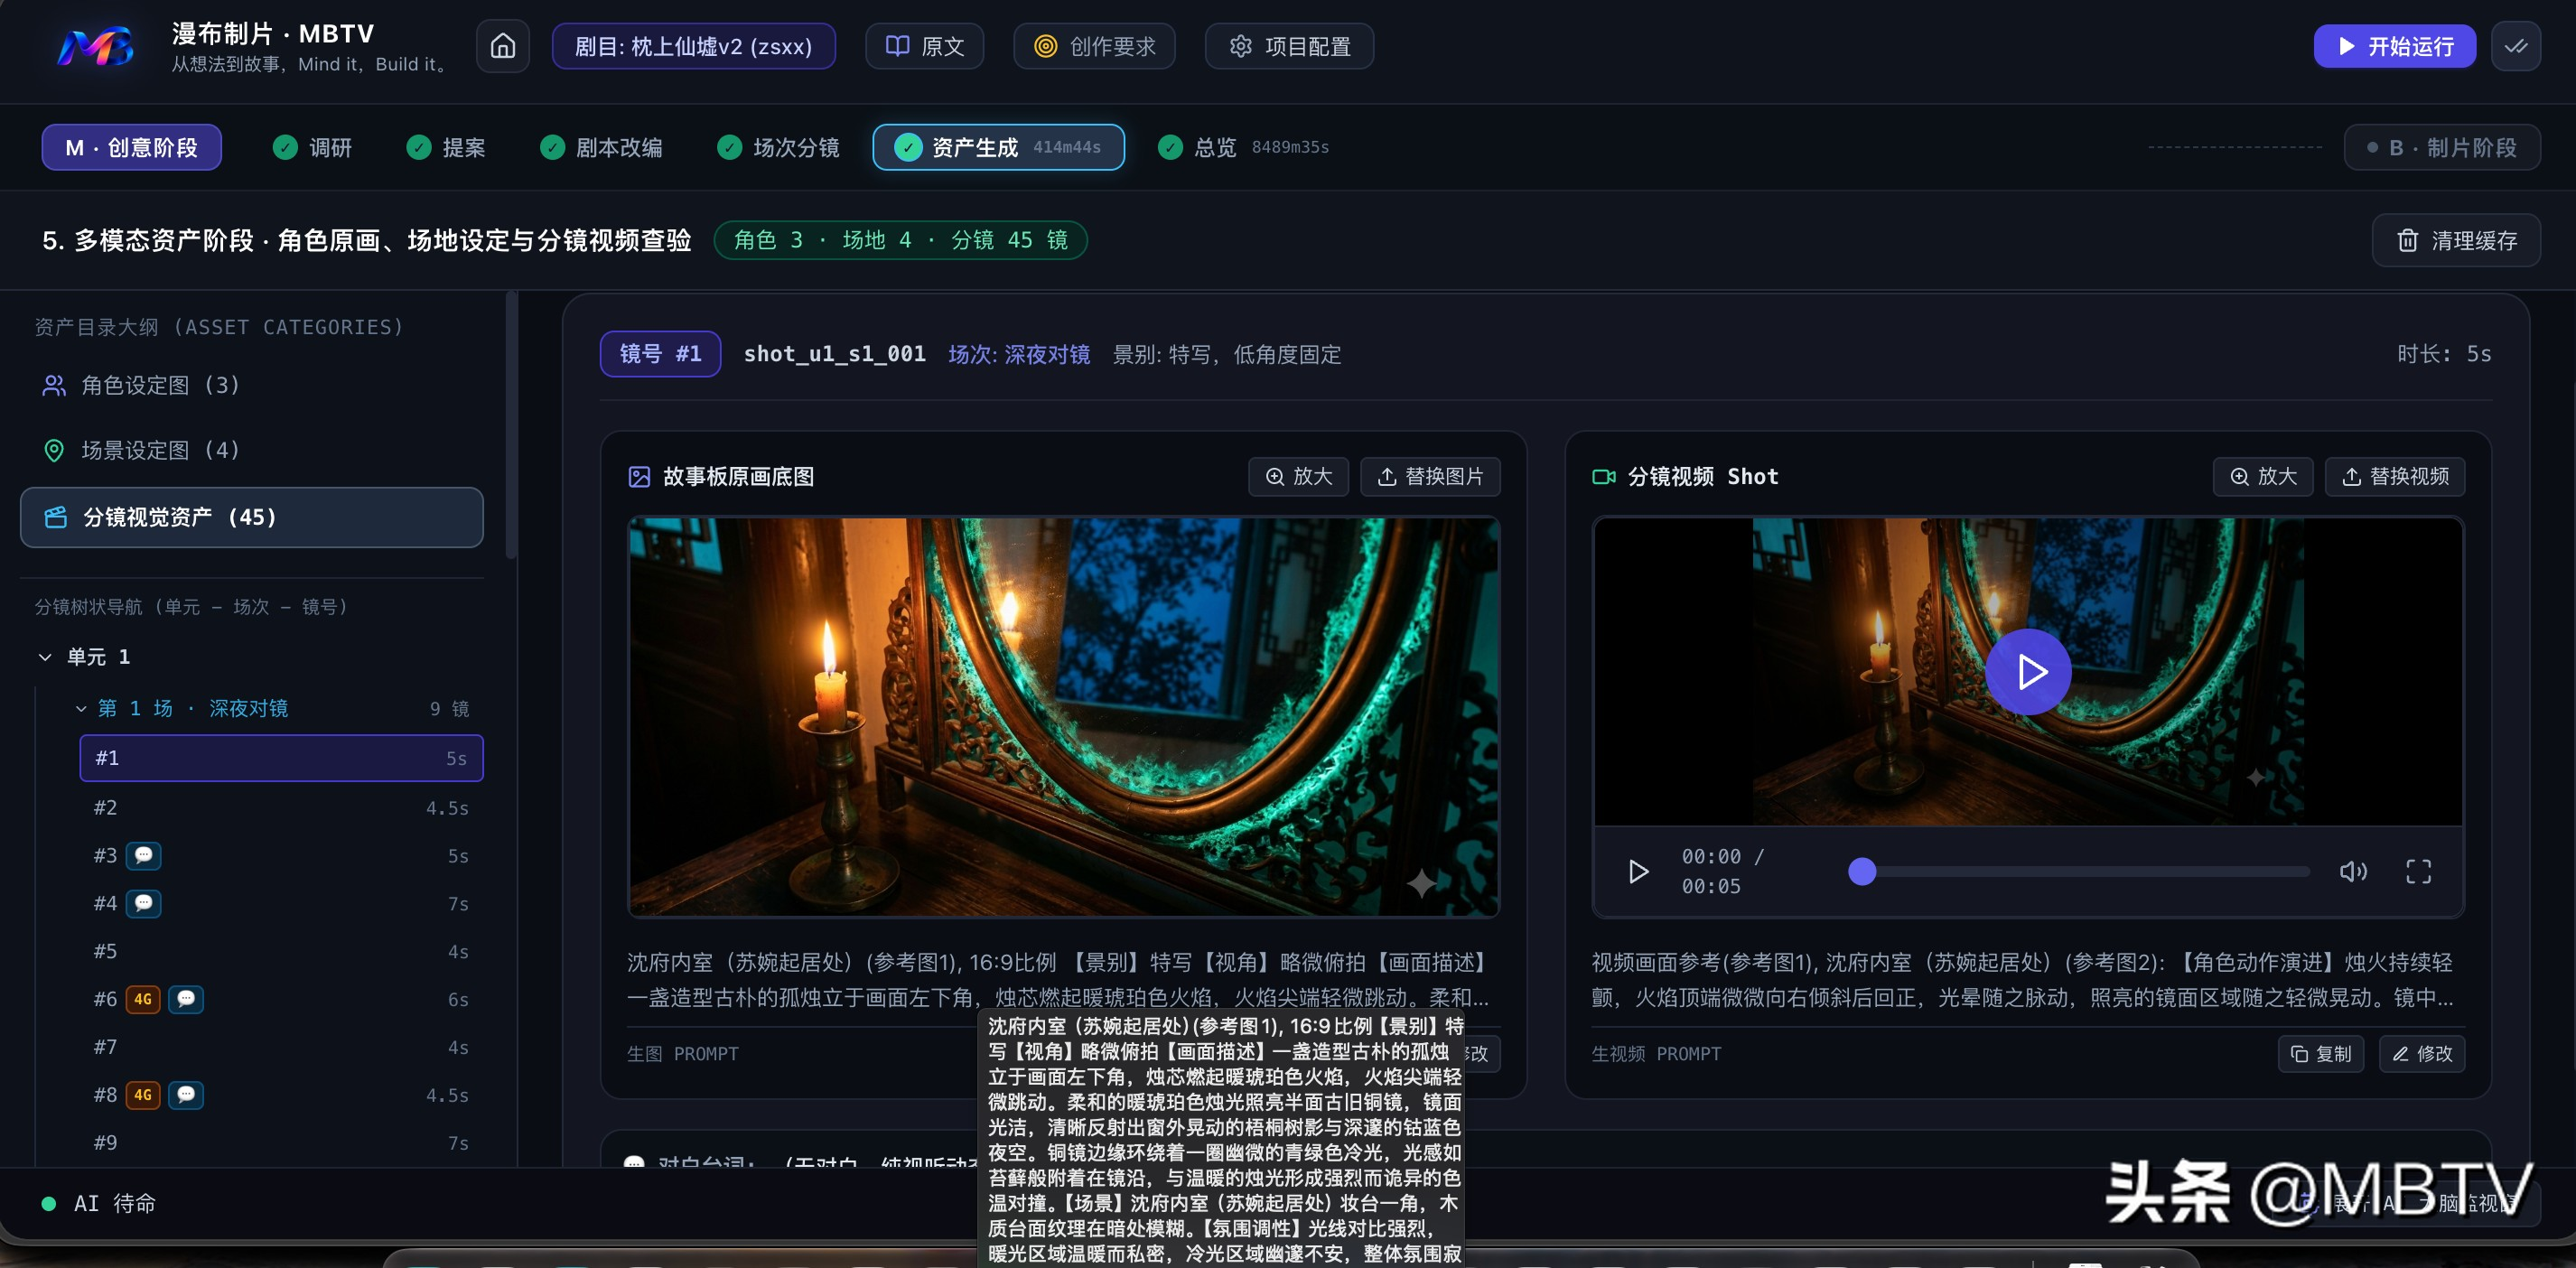
这个过程一般还生成分镜故事板参考图,来同步你脑子里的画面想象和AI想的是不是一样,这张图结合后面的视频生成提示词一起(包括人物动作、摄像机轨迹和运镜方式),才能生成视频。
这些内容MBTV都会展示所有中间数据,和最后的图片生成提示词、视频生成提示词。
你都可以拷贝下来,去豆包等平台免费生成,只是失去了自动化的快捷,但完全不阻断你的制片进度。
使用MBTV免费能完成的工作
在完全不支付图片生成API费用、视频生成API费用的前提下,MBTV可以完成如下工作:
- 剧本改编(最大支持15万字单次改编),生成工业级剧本
- 世界观提取,角色、场景设定,生成角色场景设定集
- 按场次进行分镜脚本拆解,生成全剧分镜脚本
- 编译生成角色、场景图片文生图提示词
- 编译生成每个分镜故事板参考图或四宫格参考图(根据分镜复杂度自动生成)
- 编译生成每个分镜的视频生成提示词(包括运镜提示词、人物动作提示词、台词、角色音色提示词、环境音效)
- 用户上传故事板图片,还可以合成剧本围读草稿视频(类似ppt,但使用真实分镜时长,并附加字幕和台词tts配音)
- 用户上传分镜视频,还可以自动合成粗剪版成片视频
基本上只差最后的生成步骤了,就是不停的复制、粘贴和下载保存……
不追求速度的,完全可以使用MBTV+豆包/GPT/GEMINI免费完成全片制片任务了。
接入付费API后
接入MBTV云端服务或用户自备的图片生成API和视频API后,则可以把手动逐条复制提示词(以及手动找参考图片、找前后关联)去生成图片和视频的步骤变成自动化,制片时间可能从数小时甚至数天,降到数十分钟内完成。
这才是满血版MBTV的强大威力,而不只是个“提示词编译器”。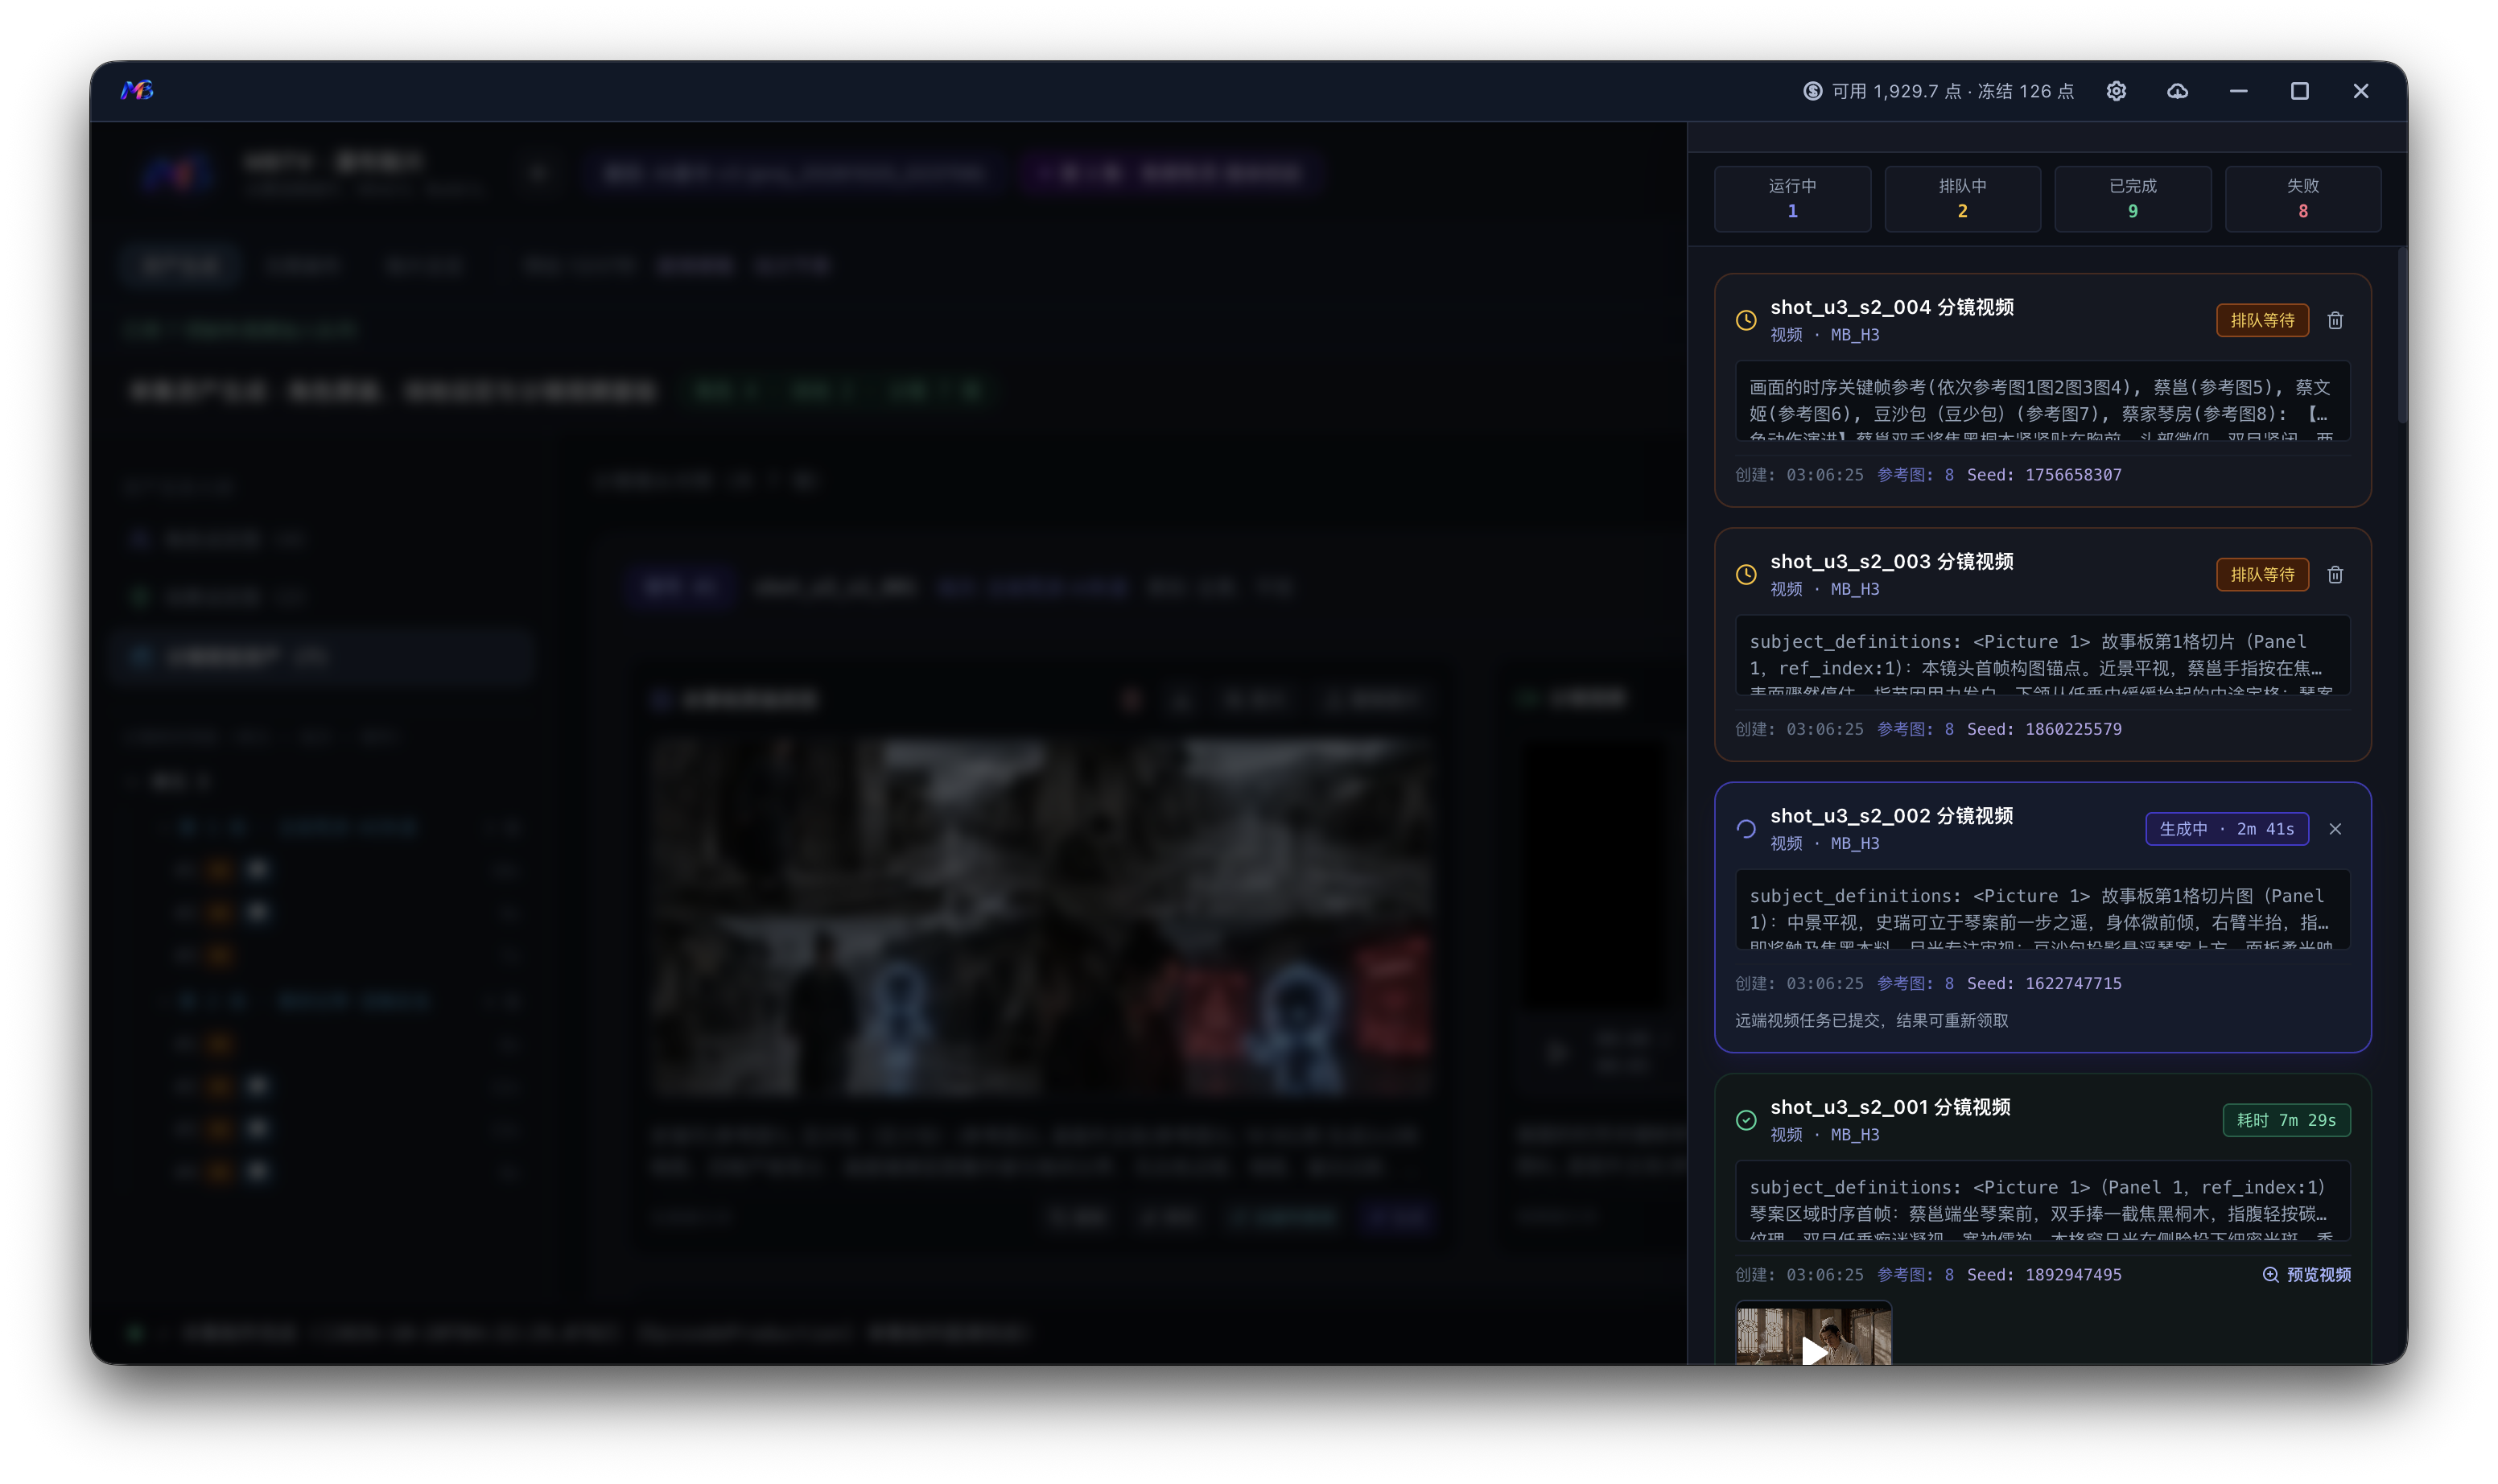
而这只是刚刚开始,MBTV真正的价值在于完成上述自动化工作后,还能继续进入MBTV的无限画布微调模式,针对本集内容中的角色、场景、画面进行精修,针对不满意的地方进行微调,达到精品剧的制作标准。